Was ist Jev? Schnelle KI-Entscheidungen ohne Textgenerierung
Erfahren Sie, wie Jev AI Zustände in typisierte Entscheidungen für Routing und Klassifizierung umwandelt – mit API-Beispielen, Preisen, Grenzen und Anwendungstipps.

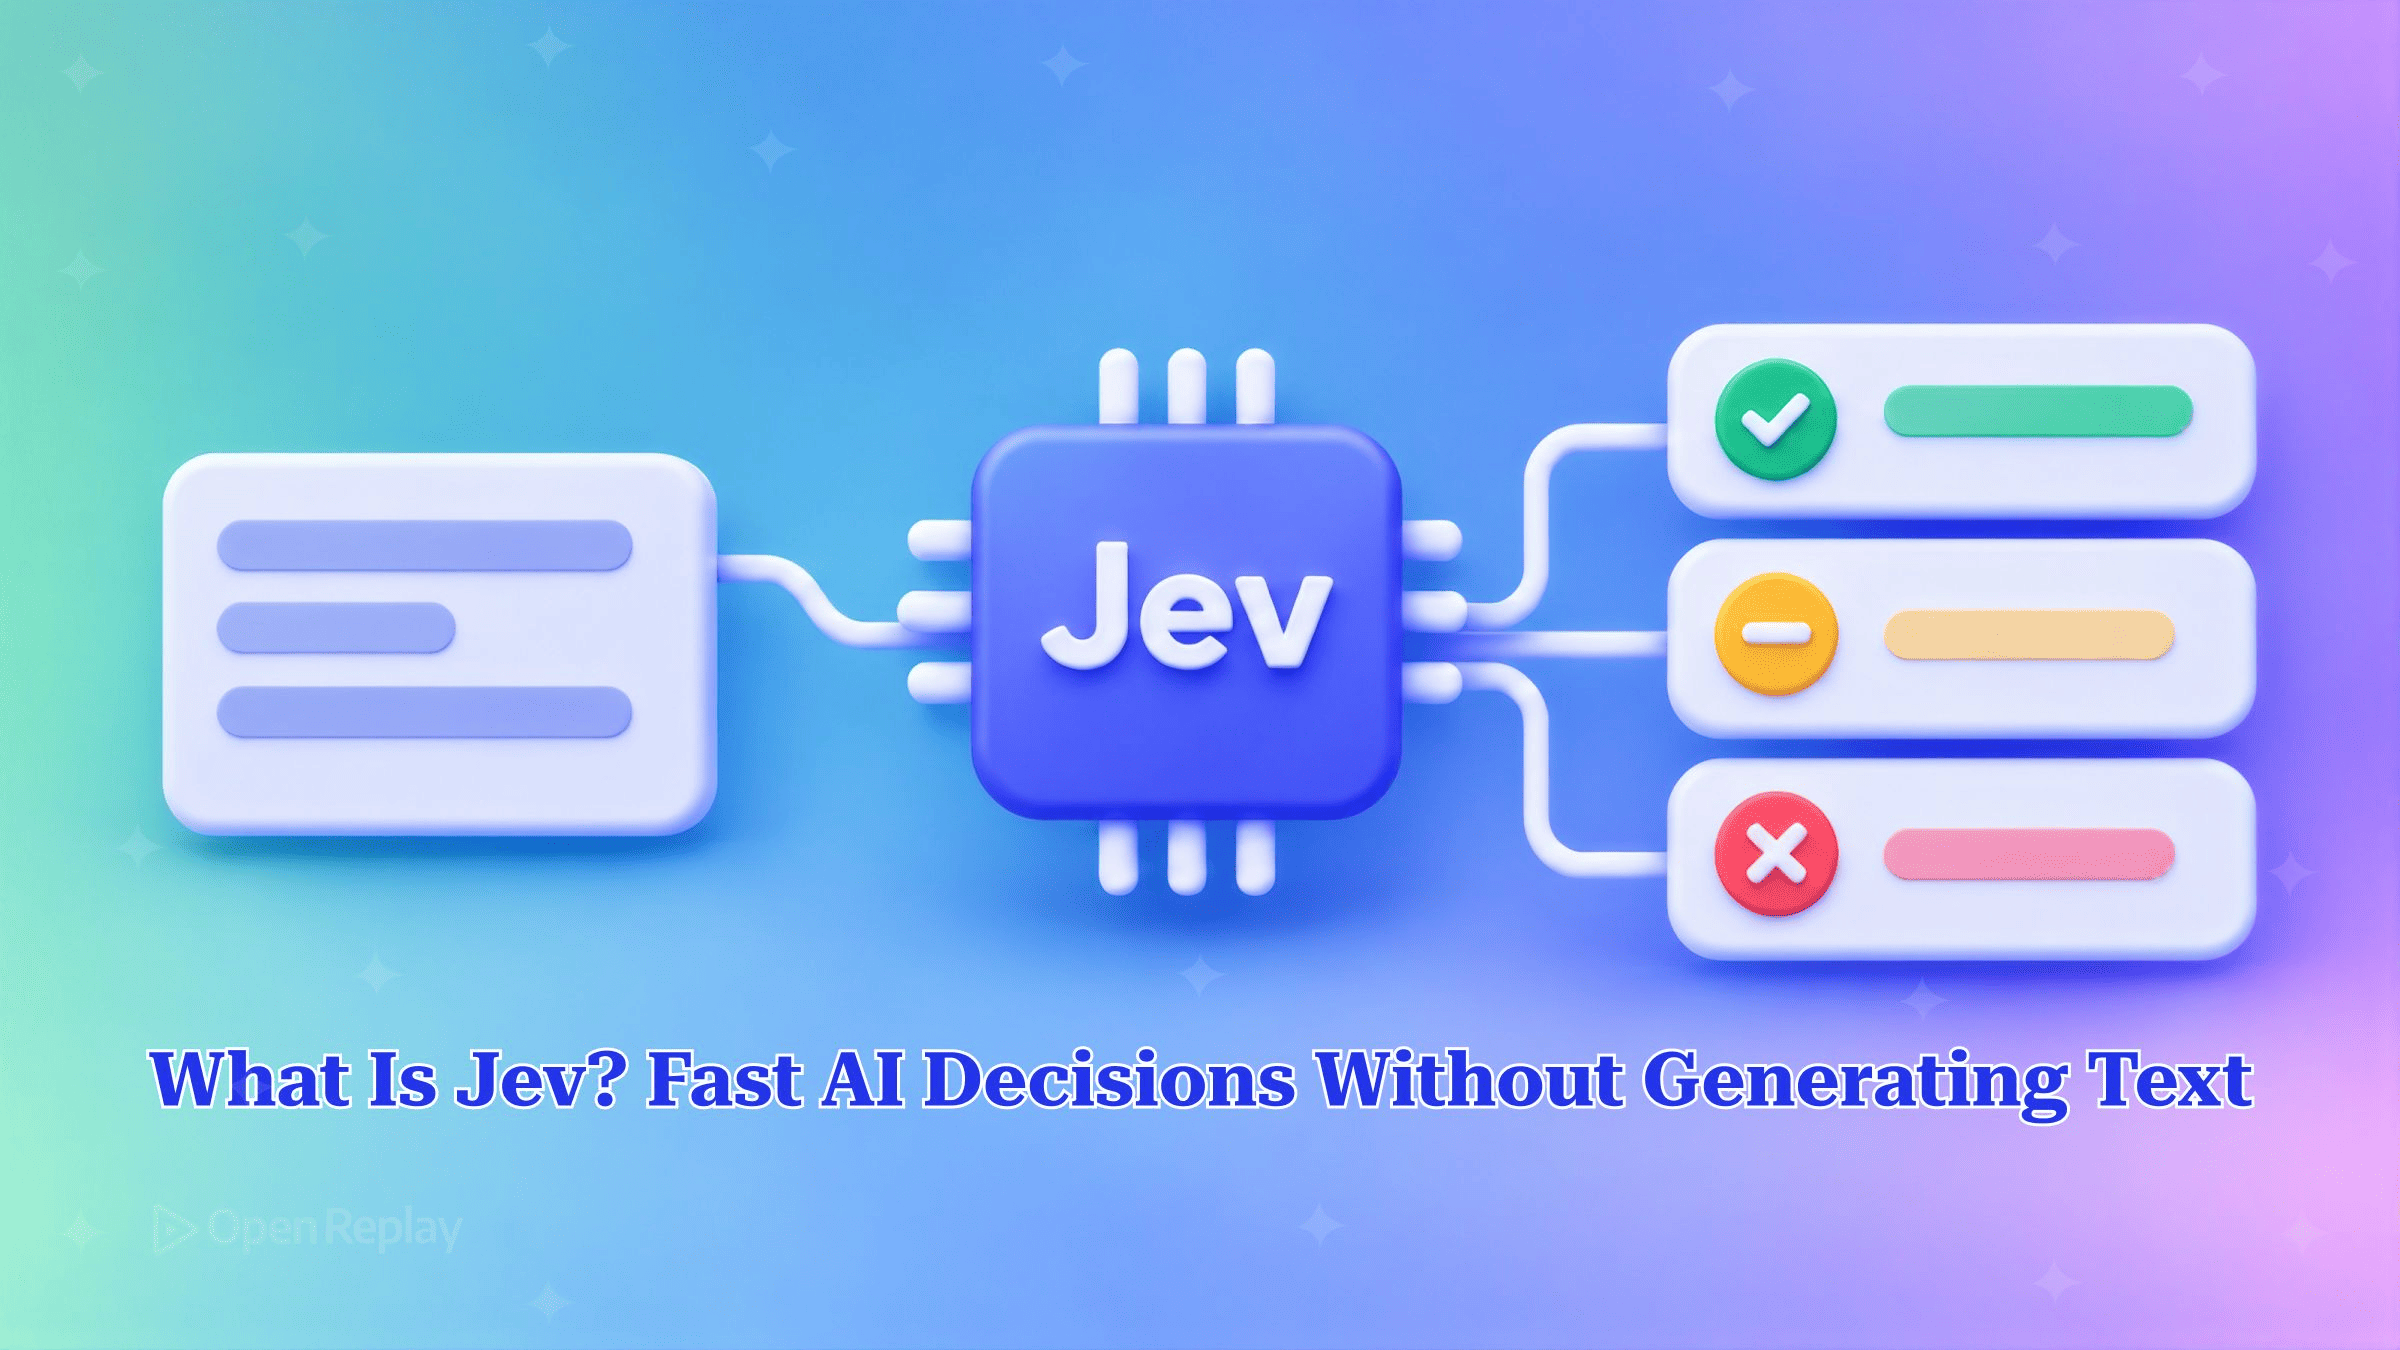
Jev ist ein Entscheidungsmodell von TypeSafe AI. Sie übergeben einen Zustand (State) und eine Reihe typisierter Fragen und erhalten eine strukturierte Antwort mit Wahrscheinlichkeiten für jede Frage zurück. Text generiert Jev nicht.
Wenn Ihr Routing-Schritt eine Chat Completion ist, die JSON anfordert und anschließend json.loads in einem try-Block ausführt, kennen Sie die Kosten bereits: Sie warten auf generierte Tokens, Sie bezahlen dafür, und hin und wieder entspricht die Ausgabe nicht Ihrem Schema. Dieser Artikel zeigt, was Jev zurückgibt, wie ein Request an den eigenen Endpunkt von TypeSafe aussieht und welche Ihrer LLM-Entscheidungsschritte Jev realistischerweise übernehmen kann.
Das Wichtigste in Kürze
- Jev ist das erste der System-One-Modelle von TypeSafe AI. Es wurde am 15. September 2026 veröffentlicht und beantwortet typisierte Fragen mit strukturierten Werten statt mit Fließtext.
- Ein Jev-Request hat drei erforderliche Top-Level-Felder:
state,modelundquestions. Die Response enthält einanswers-Objekt, dessen Schlüssel Ihre Frage-IDs sind, sowie die Token-Nutzung unterusage. - Jev bietet drei Fragetypen für Textentscheidungen. Choice wählt eine Option aus bis zu 255 aus, Score ordnet die Eingabe auf einer geordneten Bewertungsskala mit 2 bis 10 Stufen ein, und Noul liefert die Wahrscheinlichkeit, dass die Antwort auf eine Ja/Nein-Frage „Ja“ lautet.
- TypeSafe berechnet für Jev 0,042 $ pro Million Input-Tokens; Output-Tokens sind kostenlos.
- Jevs Antworten stammen immer aus dem im Request definierten Antwortraum. Das schließt Parsing- und Schemafehler aus, garantiert aber nicht, dass die Antworten korrekt sind.
Was ist Jev AI?
Jev ist ein Modell von TypeSafe AI, das dort Entscheidungen trifft, wo ein herkömmliches LLM Text schreiben würde. Es ist das erste Modell einer Klasse, die TypeSafe als System-One-Modelle bezeichnet. In der Ankündigung zum Launch beschreibt TypeSafe es als neue Klasse von Frontier-Modellen, die für schnelle, strukturierte Entscheidungen ausgelegt sind, die Software direkt weiterverarbeiten kann. Der Name lehnt sich an Kahnemans schnellen, intuitiven Denkmodus „System 1“ an. Der Zugang erfolgt über ein Early-Access-Programm.
Wie macht Jev aus einem State typisierte Antworten?
Jev nimmt einen state (Text oder JSON), eine model-Kennung und eine Map von questions entgegen und gibt pro Frage eine typisierte Antwort mit Wahrscheinlichkeiten zurück. Alle Fragen werden parallel ausgewertet. Laut Noul-Dokumentation wirken sich zusätzliche Fragen in einem Request kaum auf die Antwortzeit aus. Die Frage-IDs legen Sie selbst fest; sie werden nicht an das Modell übermittelt.
Die API-Referenz definiert drei Fragetypen für Textentscheidungen. Ein vierter Typ, box, lokalisiert einen Bereich in einem Bild und ist nur über einen experimentellen Opt-in-Header verfügbar.
| Typ | Einsatz, wenn | Eingaben | Rückgabefelder |
|---|---|---|---|
| Choice | die Antwort eine von mehreren Optionen ist | instructions sowie criteria, das jeder Option (bis zu 255) eine Beschreibung oder null zuordnet | choice, probabilities, confidence |
| Score | die Antwort ein Grad auf einer geordneten Skala ist | instructions sowie criteria als geordnetes Array mit 2 bis 10 Stufen | score, legend (Stufenindex zu Label), probabilities, confidence |
| Noul | die Antwort Ja oder Nein ist | instructions, optional criteria mit Beschreibungen für true/false | noul (Wahrscheinlichkeit von 0 bis 1) |
Eine Noul-Antwort ist eine einzelne Zahl zwischen 0 und 1 ohne separaten Konfidenzwert. Bei nur zwei möglichen Ergebnissen beschreibt eine einzige Wahrscheinlichkeit beide vollständig.
Ein Noul-Request und die Response
Der folgende Request stellt zwei Ja/Nein-Fragen zu einer einzelnen Support-Nachricht. Er wird mit einem Bearer-Token an POST https://api.typesafe.ai/v1/systemone gesendet. Requests verwenden den Alias jev-latest, und die Response gibt an, welche konkrete Version den Aufruf bedient hat. Auf der Modellseite ist aufgeführt, auf welche Version der Alias aktuell verweist.
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My order arrived damaged and I want my money back.",
    "questions": {
      "wants_refund": {
        "type": "noul",
        "instructions": "Is the customer asking for a refund?"
      },
      "mentions_damage": {
        "type": "noul",
        "instructions": "Does the customer report a damaged item?",
        "criteria": {
          "true": "Describes the product as broken, damaged, or defective",
          "false": "No mention of physical damage"
        }
      }
    }
  }'
Die Response hat die unten gezeigte Struktur. Wahrscheinlichkeiten und Token-Zahlen dienen nur der Veranschaulichung und sind keine aufgezeichnete Ausgabe. Die aufgezeichneten Beispiele in der Noul-Dokumentation von TypeSafe stammen von jev-1.13.0.
{
  "model": "jev-1.14.0",
  "answers": {
    "wants_refund": { "type": "noul", "noul": 0.97 },
    "mentions_damage": { "type": "noul", "noul": 0.95 }
  },
  "usage": { "input_tokens": 120, "output_tokens": 2 }
}
output_tokens erscheint weiterhin in usage, obwohl Output nicht abgerechnet wird. Diesen Body kann jeder beliebige HTTP-Client senden. Laut Quickstart bietet TypeSafe außerdem ein Python-SDK an (pip install typesafe-sdk, importiert als typesafe_sdk, Aufruf über client.system_one) sowie ein JavaScript/TypeScript-SDK, das als @typesafe-ai/sdk veröffentlicht ist.
Wann eignet sich Jev für Routing, Klassifizierung und Tool-Auswahl?
Jev passt zu Entscheidungsschritten mit endlichem Antwortraum: einen Request routen, ein Ticket klassifizieren, Inhalte anhand einer Bewertungsskala einstufen oder ein Tool für einen Agenten auswählen. Wenn Ihr Code bereits ein Label oder eine Zahl aus einer Chat Completion parst, ist dieser Schritt ein Kandidat.
Eine Support-Nachricht an ein Team weiterzuleiten, ist eine Choice-Frage, denn die Antwort ist genau eine von mehreren Optionen:
from typesafe_sdk import Choice, TypeSafeClient

TEAMS = {
    "billing": "Charges, invoices, refunds, payment methods",
    "technical": "Bugs, errors, outages, integration problems",
    "account": "Login, password resets, access, account settings",
}

def route_ticket(message: str) -> str:
    # TypeSafeClient reads TYPESAFE_API_KEY from the environment.
    with TypeSafeClient(model="jev-latest") as client:
        response = client.system_one(
            state=message,
            questions={
                "team": Choice(
                    instructions="Which team should handle this support message?",
                    criteria=TEAMS,
                ),
            },
        )
    answer = response.answers["team"]
    if answer.confidence < 0.8:
        return "triage"
    return answer.choice
Die Funktion gibt einen der drei Dictionary-Schlüssel zurück oder fällt auf "triage" zurück, sodass kein String validiert werden muss. Der Schwellenwert von 0,8 ist ein Platzhalter, den Sie anhand Ihres eigenen Traffics feinjustieren sollten, und keine Empfehlung von TypeSafe. Für Noul-Fragen schlägt die Dokumentation von TypeSafe 0,7 und 0,3 als Ausgangsschwellenwerte vor; alles dazwischen geht in die manuelle Prüfung.
Beim Routing lässt sich Jev auch gut mit einem Model-Gateway wie 9router kombinieren: Das Gateway leitet Requests an Modelle weiter, während Jev die Routing-Entscheidung trifft.
Was kann Jev nicht?
Jev generiert keinen Freitext. Eine Pipeline, die Jev zum Routen oder Klassifizieren einer Nachricht nutzt, braucht weiterhin ein generatives Modell, um die Antwort zu verfassen. Im Launch-Post wird der Verzicht auf Textgenerierung als bewusster Kompromiss zugunsten von Geschwindigkeit und Kosten dargestellt. In der Praxis bedeutet das: Jev wählt das Team, das Tool oder die Priorität aus, und ein LLM schreibt weiterhin die E-Mail, die Zusammenfassung oder den Code.
Welche Grenzen und Einschränkungen hat Jev?
Jev ist ein proprietäres Modell, das über die gehostete API von TypeSafe bereitgestellt wird. Gewichte hat TypeSafe nicht veröffentlicht. Ihre einzigen Stellschrauben sind die instructions und criteria, die Sie formulieren. Der Dienst befindet sich im Early Access, daher ist mit Änderungen an API-Oberfläche, Modellversionen und Preisen zu rechnen. Der Launch-Post weist selbst darauf hin, dass sich die Preise ändern können.
TypeSafe berechnet für Jev 0,042 $ pro Million Input-Tokens bei kostenlosem Output und gibt 70 bis 500 Millisekunden pro Aufruf an. Die Schlagzeilen-Werte – 193,6-mal schneller, 444,6-mal günstiger – stammen aus TypeSafes eigenen Workflow-Evaluierungen. Diese Evaluierungen bewerten Modelle anhand der gemittelten Antworten zweier großer Referenz-LLMs, und TypeSafe bezeichnet die Zugewinne als oberes Ende dessen, was in der Praxis zu erwarten ist. Im selben Benchmark erreicht Jev rund 68 % und liegt damit auf dem Niveau von LLMs der Mittelklasse. Dieser Wert misst die Übereinstimmung mit Referenzmodellen, nicht die Genauigkeit gegenüber einer von Menschen gelabelten Ground Truth. Unabhängige Tests fielen bei manchen Aufgaben schlechter aus. In einem öffentlichen Phishing-Benchmark mit 2.000 E-Mails erzielte Jev bei einer einzelnen Frage „Ist das Phishing?“ 62,6 %, Claude Haiku 4.5 dagegen 81,3 %. Benchmarken Sie Ihre eigene Aufgabe, bevor Sie etwas austauschen.
Typsicher heißt nicht korrekt. Der Antwortraum schränkt die Ausgabe ein und beseitigt damit Schemafehler, doch Jev kann trotzdem mit hoher Konfidenz die falsche Option wählen. Behandeln Sie die Wahrscheinlichkeiten als Signale, die Sie mit Schwellenwerten versehen, protokollieren und überprüfen.
Fazit
Jev macht aus einem Entscheidungsschritt einen typisierten Funktionsaufruf: State und Fragen gehen hinein, Wahrscheinlichkeiten kommen heraus, und nichts muss geparst werden. Ihr generatives Modell ersetzt Jev nicht. Es ersetzt die LLM-Aufrufe, deren einzige Aufgabe darin besteht, ein Label auszugeben. Ein sinnvoller nächster Schritt: Nehmen Sie einen bestehenden Klassifizierungs- oder Routing-Prompt, formulieren Sie ihn als Choice- oder Noul-Frage um und lassen Sie beide Varianten auf derselben Stichprobe echten Traffics laufen, bevor Sie einer von beiden vertrauen.
FAQs
Sollte ich für Fragen nach einem Grad, etwa Kompetenzniveau oder Dringlichkeit, Noul oder Score verwenden?
Verwenden Sie Score. Noul liefert nur die Wahrscheinlichkeit, dass die Antwort Ja lautet; 0,5 bedeutet also, dass das Modell unentschieden ist, nicht, dass etwas auf mittlerem Niveau liegt. Die Dokumentation von TypeSafe zeigt das anhand der Frage 'Is the candidate strong in Python?'. Für vier Lebensläufe ergaben sich Noul-Werte von 0,03, 0,14, 0,81 und 0,92. Ein vierstufiger Score ordnete dieselben Lebensläufe bei 0,0, 1,0, 2,05 und 2,89 ein – jeweils auf oder nahe einer vom Entwickler definierten Stufe.
Wie gehe ich mit einer Entscheidung um, die mehr als 255 Optionen in einer Choice-Frage erfordert?
Teilen Sie sie in zwei Stufen auf. Eine einzelne Choice-Frage akzeptiert bis zu 255 Optionen. Für größere Mengen beschreibt der Launch-Post von TypeSafe, die Kandidaten zunächst unabhängig voneinander zu bewerten und anschließend eine explizite Choice-Frage über die besten paar Kandidaten laufen zu lassen. Laut TypeSafe ist das langsamer als ein einzelner Aufruf. Die Optionsbeschreibungen sind Teil des Requests und zählen daher auch gegen das Kontextlimit von 64k Tokens pro Request.
Funktioniert Jev mit dem Vercel AI SDK?
Ja. Vercel stellt den Provider @ai-sdk/typesafe-ai bereit, und das Vercel AI Gateway führt Jev unter der Modell-ID typesafe-ai/jev. Die Aufrufe laufen über eine experimentelle Funktion des AI SDK 7, deren Name und Signatur sich daher noch ändern können. Der Provider benennt Noul in 'boolean' um und liefert die Antwort im Feld probability statt in noul. Eine aus der TypeSafe-Dokumentation übernommene Frage muss daher ihren Typ von 'noul' auf 'boolean' ändern. Choice und Score behalten ihre Namen.
Wie viel Input darf ein einzelner Jev-Request enthalten?
Standardmäßig muss ein Jev-Request zwei Limits einhalten: 64k Tokens für den State plus alle Fragen und 32k Tokens für den State plus jeweils eine einzelne Frage. Eine separate Obergrenze für die Anzahl der Fragen gibt es nicht. Wird der Header TypeSafe-Danger-Zone-Long-Context auf true gesetzt, steigen beide Limits bei Jev 1.13 und 1.14 auf 262k Tokens. Laut TypeSafe ist Long Context langsamer und weniger genau als die Standardlimits; aktivieren Sie ihn daher nur für Requests, die ihn tatsächlich benötigen.
Gain Debugging Superpowers
Unleash the power of session replay to reproduce bugs, track slowdowns and uncover frustrations in your app. Get complete visibility into your frontend with OpenReplay — the most advanced open-source session replay tool for developers.
Star on GitHub12k