ZIP-Dateien in Node ohne Bibliothek lesen und schreiben
ZIP-Dateien mit der experimentellen node:zlib-API in Node.js 26.8.0 lesen und erstellen. Mit Streaming-Beispielen, Schutz vor Zip-Slip und Alternativen für ältere Versionen.

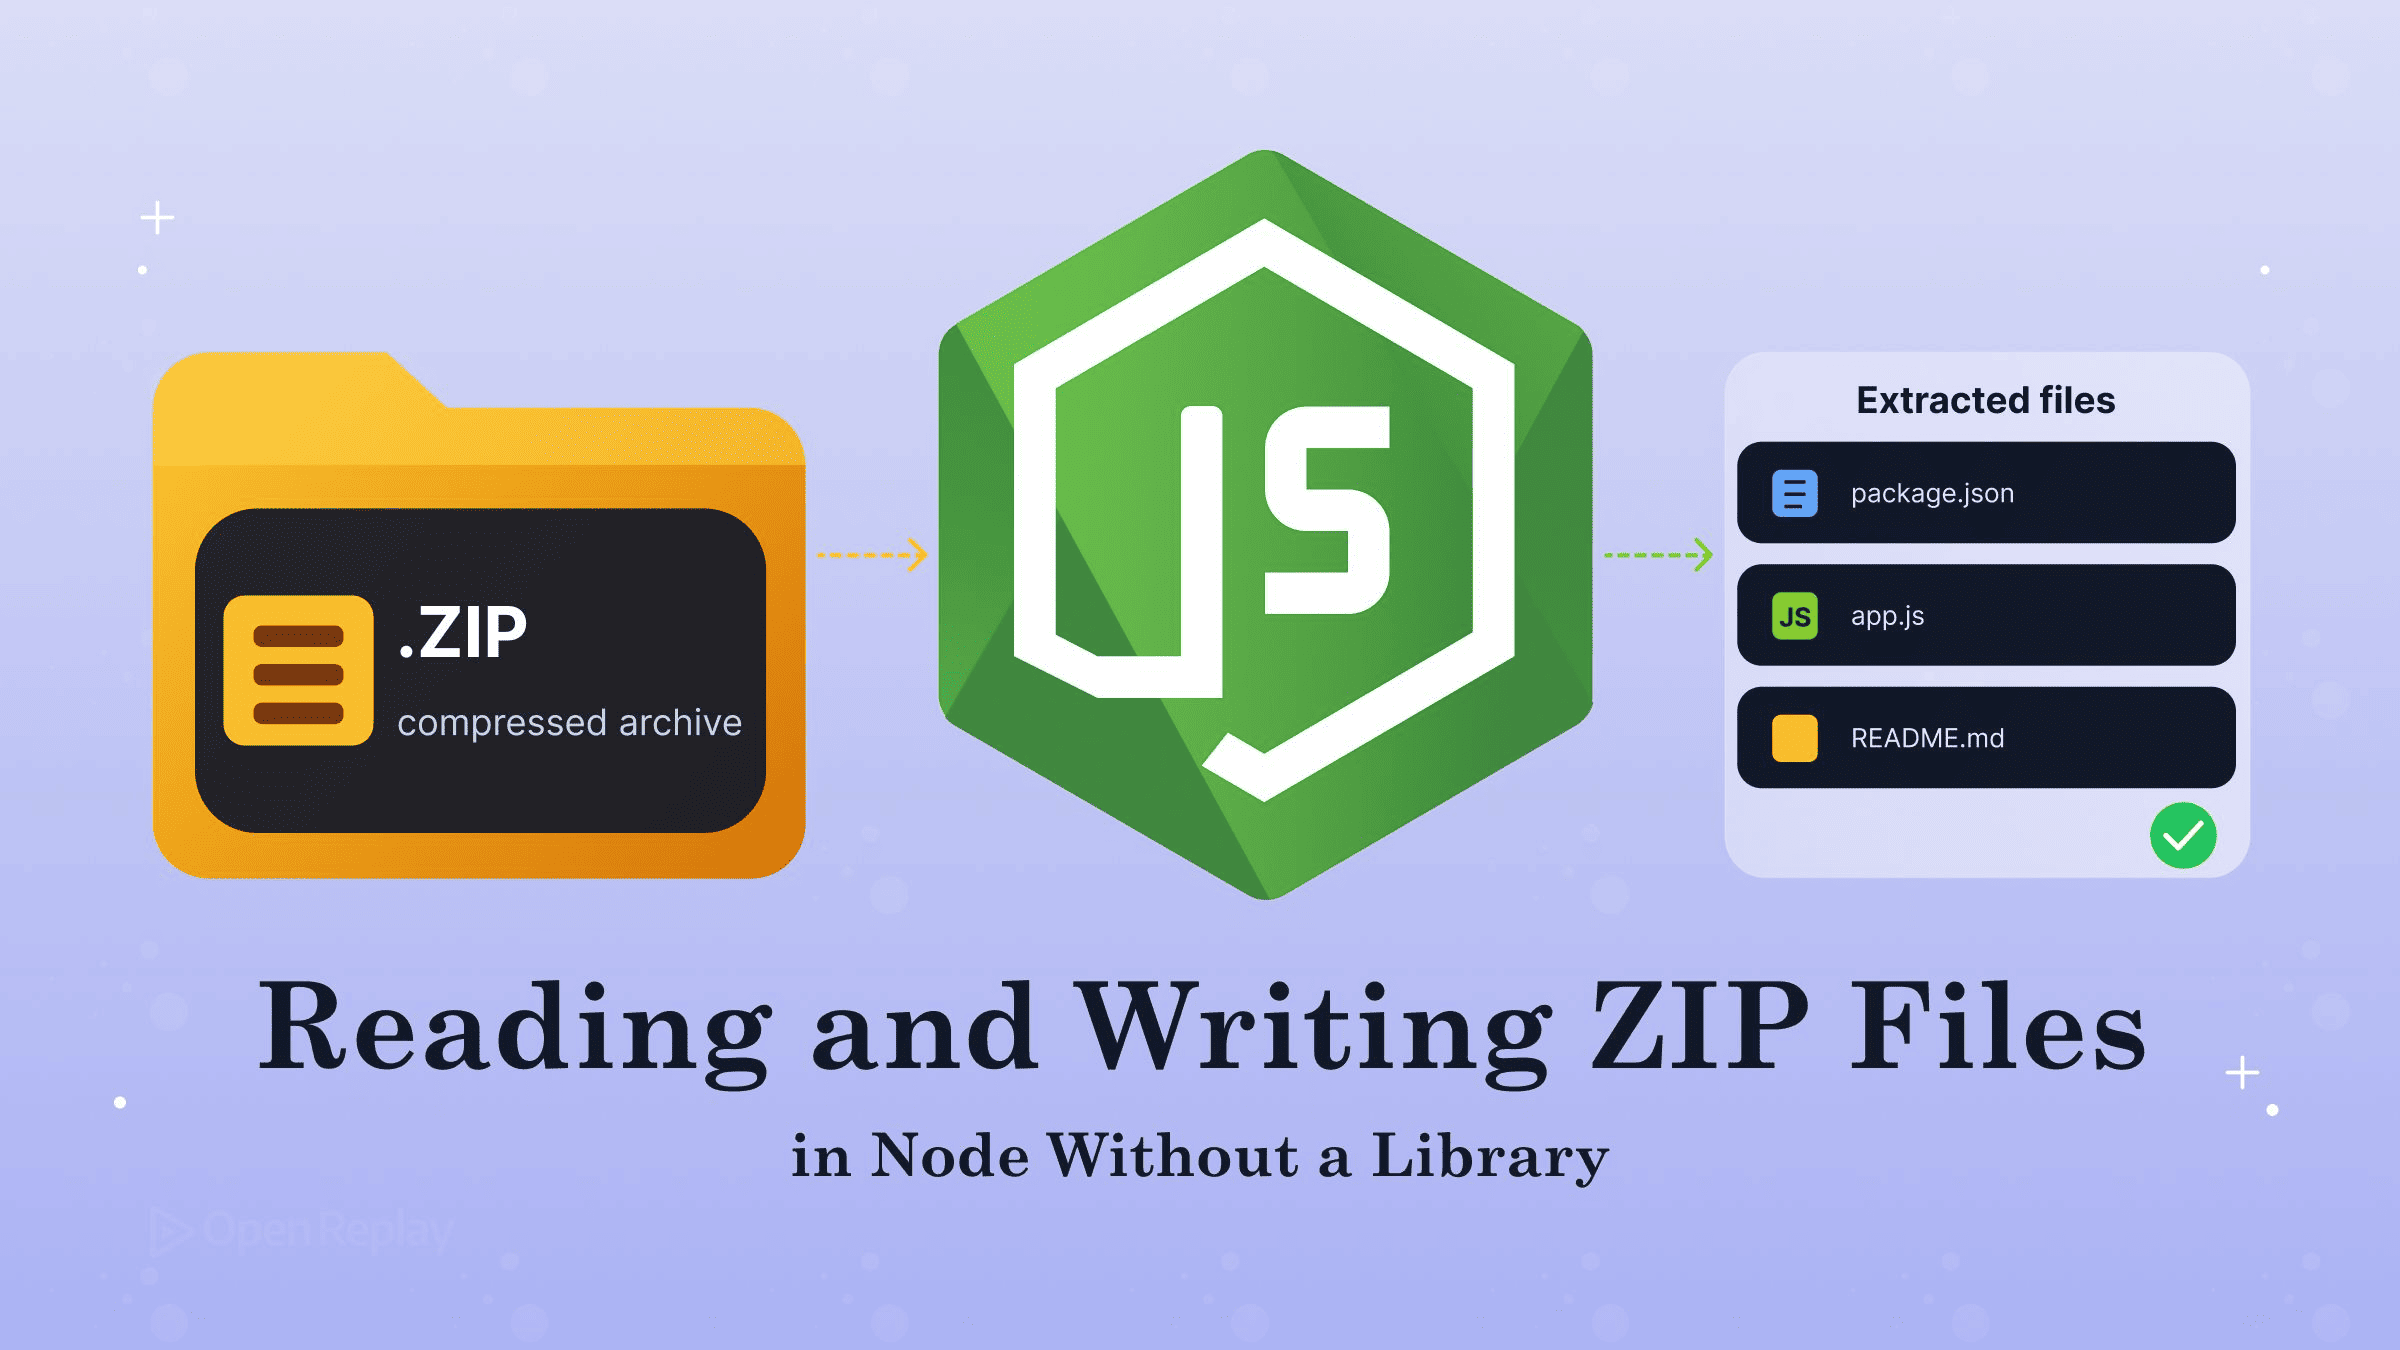
Ab Node.js 26.8.0 kann das integrierte Modul node:zlib ZIP-Archive selbstständig lesen und schreiben. adm-zip, archiver und yauzl werden damit überflüssig. Die API ist experimentell.
Die meisten Node-Projekte, die Uploads entgegennehmen oder Release-Artefakte erzeugen, haben mindestens ein ZIP-Paket als Abhängigkeit, oft sogar zwei: yauzl zum Lesen und archiver zum Schreiben. Beide sind Drittanbietercode, der nicht vertrauenswürdige Binärdaten verarbeitet.
Die Funktion wurde mit dem Release von Node.js 26.8.0 am 26. August 2026 über PR #64339 ausgeliefert. Die ZIP-Archiv-API ist experimentell. Der erste Aufruf eines beliebigen Teils davon gibt eine Experimental-Warnung aus, der bloße Import von node:zlib hingegen nicht. Bisher enthält kein Release von Node 24 LTS die Funktion: Die ZIP-Klassen fehlen in den 24.x-Changelogs bis einschließlich 24.21.0. Das entspricht dem Muster der anderen integrierten Node.js-APIs, die npm-Pakete ersetzen. Die API ist neu und ändert sich noch. Prüfen Sie daher die genauen Signaturen in der node:zlib-Dokumentation, bevor Sie Code in Produktion bringen.
Das Wichtigste in Kürze
- Node.js 26.8.0 hat
node:zlibum experimentelle Lese- und Schreibunterstützung für ZIP erweitert, und zwar überZipFile,ZipBuffer,ZipEntryundcreateZipArchive(). ZipEntry.content()lädt einen Eintrag vollständig in den Speicher, währendcontentIterator()ihn als Folge von Buffer-Chunks streamt.setMaxZipContentSize()legt die Standardobergrenze für gepufferte Lesevorgänge wiecontent()fest. FürcontentIterator()gilt diese Grenze nicht. Dort steuern Sie das Limit stattdessen pro Aufruf über die eigene OptionmaxSize.- Die ZIP-API weist Eintragsnamen mit
../oder absoluten Pfaden nicht zurück. Jede Extraktionsroutine benötigt daher eine eigene Zip-Slip-Prüfung. - Unter Node 24 LTS sollten Sie weiterhin yauzl zum Lesen und archiver zum Schreiben verwenden.
| Paket | Aufgabe | Integrierter Ersatz |
|---|---|---|
| adm-zip | Komplette Archive im Speicher lesen/schreiben | ZipBuffer, ZipFile, createZipArchive() |
| yauzl | Lesen per Streaming | ZipFile + contentIterator() |
| archiver | Schreiben per Streaming | ZipEntry.create()/createStream() + createZipArchive() |
Wie liest man eine ZIP-Datei in Node.js mit ZipFile?
Um ein ZIP-Archiv auf der Festplatte in Node.js zu lesen, öffnen Sie es mit ZipFile.open(), iterieren über die Einträge und rufen content() für den gewünschten Eintrag auf. ZipFile arbeitet über einen File Descriptor. Es springt direkt zum angeforderten Eintrag, liest ihn erst bei Bedarf von der Festplatte und behält den Inhalt danach nicht im Speicher. ZipBuffer erfüllt dieselbe Aufgabe für ein Archiv, das bereits im Speicher liegt, etwa einen Upload in einem Buffer. Dabei liest es direkt aus diesem Speicher, ohne die Daten zu kopieren. ZipEntry repräsentiert einen einzelnen Eintrag.
// Requires Node 26.8.0+ (experimental)
import { ZipFile } from 'node:zlib';

const zip = await ZipFile.open('upload.zip');
try {
  for await (const entry of zip.values()) {
    console.log(entry.name, entry.size);
  }
  if (zip.has('README.md')) {
    const readme = await zip.get('README.md');
    const buf = await readme.content({ maxSize: 1024 * 1024 });
    console.log(buf.toString('utf8'));
  }
} finally {
  await zip.close();
}
zip.get() wird mit ERR_ZIP_ENTRY_NOT_FOUND abgelehnt (rejected), wenn das Archiv keinen Eintrag mit diesem Namen enthält. Deshalb prüft das Beispiel zuerst mit zip.has(). zipFile.values() liefert einen Iterator, dessen Elemente jeweils ein Promise sind, das zu einem ZipEntry aufgelöst wird. Aus diesem Grund passt hier for await. Jeder Eintrag stellt name und size bereit, wobei size die unkomprimierte Größe in Bytes angibt. Die asynchronen Aufrufe gibt es auch in synchroner Form (openSync(), contentSync(), valuesSync()). Ausgenommen sind die Streaming-APIs: Für contentIterator() und ZipEntry.createStream() gibt es kein synchrones Gegenstück.
Große Archive mit contentIterator() streamen
Um große ZIP-Einträge in Node.js zu lesen, verwenden Sie contentIterator(). Die Methode liefert den dekomprimierten Inhalt als Folge von Buffer-Chunks, sodass der vollständige Eintrag nie auf einmal im Speicher liegen muss. Da es sich um ein Async Iterable handelt, können Sie es direkt an pipeline() übergeben. Das Pull-basierte Modell ist dasselbe, das in Wie Streams für Webentwickler funktionieren beschrieben wird.
// Requires Node 26.8.0+ (experimental)
import { ZipFile, setMaxZipContentSize } from 'node:zlib';
import { createWriteStream } from 'node:fs';
import { mkdir } from 'node:fs/promises';
import path from 'node:path';
import { pipeline } from 'node:stream/promises';
import { safeDestination } from './safe-destination.js';

setMaxZipContentSize(32 * 1024 * 1024); // caps buffered content() reads
const MAX_ENTRY_BYTES = 2 * 1024 ** 3;

const zip = await ZipFile.open('large.zip');
try {
  for await (const entry of zip.values()) {
    if (entry.isSymlink) continue; // don't recreate links from untrusted archives
    const target = safeDestination('out', entry.name);
    if (entry.name.endsWith('/')) {
      await mkdir(target, { recursive: true });
      continue;
    }
    if (entry.size > MAX_ENTRY_BYTES) throw new Error(`Too large: ${entry.name}`);
    await mkdir(path.dirname(target), { recursive: true });
    await pipeline(entry.contentIterator(), createWriteStream(target));
  }
} finally {
  await zip.close();
}
setMaxZipContentSize() schützt vor Zip-Bomben, also Uploads, die komprimiert klein sind, sich beim Entpacken aber auf eine enorme Größe aufblähen können. Die Funktion legt die modulweite Standardobergrenze für gepufferte Lesevorgänge wie content() fest. Laut Dokumentation gilt dieser Standardwert nicht für contentIterator(), weil beim Streaming nie eine einzelne große Speicherallokation erfolgt. Die Option maxSize von content() wird pro Aufruf angegeben. Sie weist jeden Eintrag zurück, dessen deklarierte unkomprimierte Größe den übergebenen Wert überschreitet. Lassen Sie die Option weg, verwendet content() das modulweite Limit aus getMaxZipContentSize(). contentIterator() akzeptiert eine eigene Option maxSize, die standardmäßig kein Limit hat.
Für das Lesen per Streaming gibt es eine separate Schutzmaßnahme. Ein nachträglicher Hardening-PR erläutert, dass der Streaming-Decoder nie mehr Bytes erzeugt, als die deklarierte unkomprimierte Größe des Eintrags angibt. Versuchen die Daten, sich über diese Größe hinaus aufzublähen, wird sofort ERR_ZIP_ENTRY_CORRUPT geworfen. Deshalb prüft die obige Schleife entry.size, bevor das Streaming beginnt.
Wie schreibt man ein ZIP-Archiv aus einem Ordner?
Um in Node.js ein ZIP-Archiv zu erstellen, legen Sie pro Datei einen ZipEntry an und übergeben die Liste an createZipArchive(). Die Funktion macht aus diesen Einträgen einen Readable Stream mit den Archiv-Bytes. Diesen Stream leiten Sie anschließend per Pipe in eine Datei. Sammeln Sie zunächst die Dateien mit fs.readdir und dessen Option recursive:
// collect-files.js
import { readdir, lstat } from 'node:fs/promises';
import path from 'node:path';

export async function collectFiles(root) {
  const files = [];
  for (const rel of await readdir(root, { recursive: true })) {
    const abs = path.join(root, rel);
    if (!(await lstat(abs)).isFile()) continue; // skips dirs and symlinks
    files.push({ abs, name: rel.split(path.sep).join('/') });
  }
  return files.sort((a, b) => a.name.localeCompare(b.name));
}
Da die Funktion lstat verwendet, überspringt sie symbolische Links, statt ihnen zu folgen. Anschließend serialisieren Sie die Einträge:
// Requires Node 26.8.0+ (experimental)
import { readFile } from 'node:fs/promises';
import { createWriteStream } from 'node:fs';
import { pipeline } from 'node:stream/promises';
import { ZipEntry, createZipArchive } from 'node:zlib';
import { collectFiles } from './collect-files.js';

const entries = [];
for (const f of await collectFiles('dist')) {
  entries.push(await ZipEntry.create(f.name, await readFile(f.abs)));
}
const archive = await createZipArchive(entries);
await pipeline(archive, createWriteStream('release.zip'));
ZipEntry.create() erwartet zuerst den Dateinamen und dann die Daten. Die synchrone Variante ist als zlib.ZipEntry.createSync(filename, data, options) dokumentiert. Dieses Beispiel puffert jede Datei vollständig, bevor sie hinzugefügt wird. Für große Dateien verwenden Sie stattdessen ZipEntry.createStream(). Damit wird die Quelle komprimiert, während createZipArchive() das Archiv schreibt, sodass die Datei nie komplett im Speicher gehalten werden muss. Ein Streaming-Eintrag lässt sich nur einmal verwenden: Nachdem createZipArchive() ihn geschrieben hat, ist sein Inhalt verbraucht und kann nicht erneut gelesen werden.
Verschachtelte Ordner und Schutz vor Zip-Slip
Pfade innerhalb eines ZIP-Archivs verwenden Schrägstriche (/), unabhängig davon, auf welchem Betriebssystem das Archiv erstellt wurde. Die Spezifikation des ZIP-Dateiformats schreibt dies im Abschnitt zu Dateinamen (4.4.17) vor. collectFiles wandelt deshalb path.sep in / um, sodass ein Windows-Pfad wie assets\img\logo.png als assets/img/logo.png gespeichert wird. Eintragsnamen, die auf / enden, sind Verzeichnisse.
Zip-Slip ist ein Path-Traversal-Angriff. Dabei enthält ein manipuliertes Archiv einen Eintrag mit einem Namen wie ../../etc/passwd, den eine naive Extraktionsroutine außerhalb des Zielverzeichnisses schreibt. Die integrierte API gibt solche Namen genau so weiter, wie sie im Archiv stehen, ohne Bereinigung und ohne Fehlermeldung. Die Prüfung liegt also in Ihrer Verantwortung. Lösen Sie jeden Namen relativ zum Zielverzeichnis auf und weisen Sie alles zurück, was außerhalb davon landet:
// safe-destination.js
import path from 'node:path';

export function safeDestination(destDir, entryName) {
  if (entryName.includes('\0')) throw new Error(`NUL byte in ${entryName}`);
  const root = path.resolve(destDir);
  const target = path.resolve(root, entryName);
  if (target !== root && !target.startsWith(root + path.sep)) {
    throw new Error(`Blocked entry outside ${root}: ${entryName}`);
  }
  return target;
}
Die Funktion weist sowohl Traversal mit ../ als auch absolute Namen wie /etc/passwd zurück. Rufen Sie sie für jeden entry.name auf, bevor Sie etwas schreiben. Bei Symlink-Einträgen ist dieselbe Vorsicht geboten. Die Dokumentation warnt, dass jede Extraktionsroutine, die einen Symlink-Eintrag berücksichtigt, einen echten Link auf der Festplatte erzeugt. Dem Ziel dieses Links können Sie nicht vertrauen. Am einfachsten überspringen Sie Einträge, bei denen entry.isSymlink den Wert true hat, wie es die obige Streaming-Schleife tut.
Auf älteren Node-Versionen oder LTS: yauzl und archiver beibehalten
Wenn Sie Node 24 LTS oder älter einsetzen, verwenden Sie weiterhin yauzl zum Lesen und archiver zum Schreiben. Neue Funktionen aus der Current-Linie können per Backport in eine aktive LTS-Linie übernommen werden. Prüfen Sie daher die 24.x-Changelogs, bevor Sie die Pakete entfernen. Behalten Sie die Pakete, bis die API in der Node-Version verfügbar ist, die Sie in Produktion betreiben. Mit einer Laufzeitprüfung kann gemeinsam genutztes Tooling den passenden Weg wählen:
const [major, minor] = process.versions.node.split('.').map(Number);
const hasNativeZip = major > 26 || (major === 26 && minor >= 8);
Der folgende archiver-Code wird durch die integrierte API ersetzt. Archiver 8 hat den Default-Export entfernt, daher verwendet das Beispiel die benannte Klasse ZipArchive. Unter archiver 7 und älter schreiben Sie stattdessen import archiver from 'archiver' und archiver('zip'):
import { ZipArchive } from 'archiver'; // archiver 8+
import { createWriteStream } from 'node:fs';
import { once } from 'node:events';

const output = createWriteStream('release.zip');
const closed = once(output, 'close');
const archive = new ZipArchive();
archive.pipe(output);
archive.directory('dist/', false);
await archive.finalize();
await closed; // release.zip is fully written and closed
finalize() wird aufgelöst, sobald archiver keine weiteren Daten mehr erzeugt, und nicht erst, wenn die Datei geflusht und geschlossen wurde. Erst nach dem close-Event des Ausgabestreams können Sie release.zip gefahrlos sofort weiterverarbeiten.
Fazit
Ab Node 26.8.0 deckt node:zlib die alltäglichen ZIP-Aufgaben ab: Lesen mit ZipFile, Streamen großer Einträge mit contentIterator() und Schreiben mit ZipEntry und createZipArchive(). Damit ist alles abgedeckt, wofür bisher adm-zip, archiver und yauzl zuständig waren. Da die API experimentell ist, sollten Sie Ihre Node-Version fixieren, die Zip-Slip-Prüfung und die Größenlimits beibehalten und die node:zlib-Dokumentation bei jedem Upgrade erneut lesen. Ein guter erster Schritt besteht darin, einen einzelnen Lesepfad, etwa das Entpacken von Uploads, hinter der hasNativeZip-Prüfung umzustellen. Behalten Sie den Paket-Fallback bei, bis Ihre Produktionsumgebung die API unterstützt.
FAQs
Was passiert, wenn zwei Einträge denselben Namen haben und ich in Node createZipArchive() aufrufe?
createZipArchive() schreibt beide Einträge. Die Funktion schreibt die Einträge in der Reihenfolge, in der sie übergeben werden, und prüft nicht auf doppelte Namen. Das Archiv enthält dann Duplikate, und die meisten Entpackwerkzeuge behalten die jeweils zuletzt vorkommende Kopie. Die add()-Methoden von ZipBuffer und ZipFile verhalten sich anders: Sie ersetzen einen bereits vorhandenen Eintrag mit demselben Namen. Wenn Ihre Dateiliste doppelte Pfade enthalten kann, sollten Sie sie vor dem Serialisieren deduplizieren.
Kann node:zlib ZIP-Archive mit mehr als 4 GB schreiben?
Ja. createZipArchive() wechselt automatisch zu Zip64-Strukturen, sobald die Anzahl der Einträge oder ein Offset bzw. eine Größe nicht mehr in die ursprünglichen 16- und 32-Bit-Felder des ZIP-Formats passt. Das betrifft Einträge oder Archive mit mehr als 4 GB sowie Archive mit mehr als 65.535 Einträgen. Dafür ist keine Option erforderlich. ZipBuffer.toBuffer() wechselt beim Serialisieren der Einträge auf dieselbe Weise zu Zip64.
Welche Fehlercodes sollte ich beim Lesen von ZIP-Einträgen mit node:zlib behandeln?
Behandeln Sie ERR_ZIP_ENTRY_TOO_LARGE, das ausgelöst wird, wenn die deklarierte Größe eines Eintrags maxSize überschreitet, sowie ERR_ZIP_ENTRY_CORRUPT, das ausgelöst wird, wenn die CRC-32-Prüfsumme des Inhalts nicht stimmt oder seine Länge von der deklarierten Größe abweicht. Wird ein Name angefordert, den das Archiv nicht enthält, erhalten Sie ERR_ZIP_ENTRY_NOT_FOUND (ZipFile.get() wird damit abgelehnt). Seit dem Hardening durch PR 65016 werden Archive, deren lokale Header und Central-Directory-Header nicht übereinstimmen, mit ERR_ZIP_INVALID_ARCHIVE zurückgewiesen.
Welche Kompressionsverfahren verwendet die integrierte ZIP-API von Node?
Die node:zlib-Dokumentation nennt Deflate und Zstandard als Kompressionsverfahren für komprimierte Einträge. Einträge können auch unkomprimiert gespeichert werden. Jeder ZipEntry besitzt die boolesche Eigenschaft compressed: Sie ist true, wenn eines der beiden Verfahren verwendet wurde, und false, wenn der Inhalt ohne Kompression gespeichert wurde. Die Dokumentation bezeichnet diese Liste als aktuellen Stand, und die API ist experimentell. Prüfen Sie daher die Dokumentation Ihrer Node-Version.
Gain Debugging Superpowers
Unleash the power of session replay to reproduce bugs, track slowdowns and uncover frustrations in your app. Get complete visibility into your frontend with OpenReplay — the most advanced open-source session replay tool for developers.
Star on GitHub12k