Lectura y escritura de archivos ZIP en Node sin bibliotecas externas
Lee y crea archivos ZIP con la API experimental node:zlib de Node.js 26.8.0. Consulta ejemplos de streaming, protección contra zip-slip y alternativas para versiones anteriores.

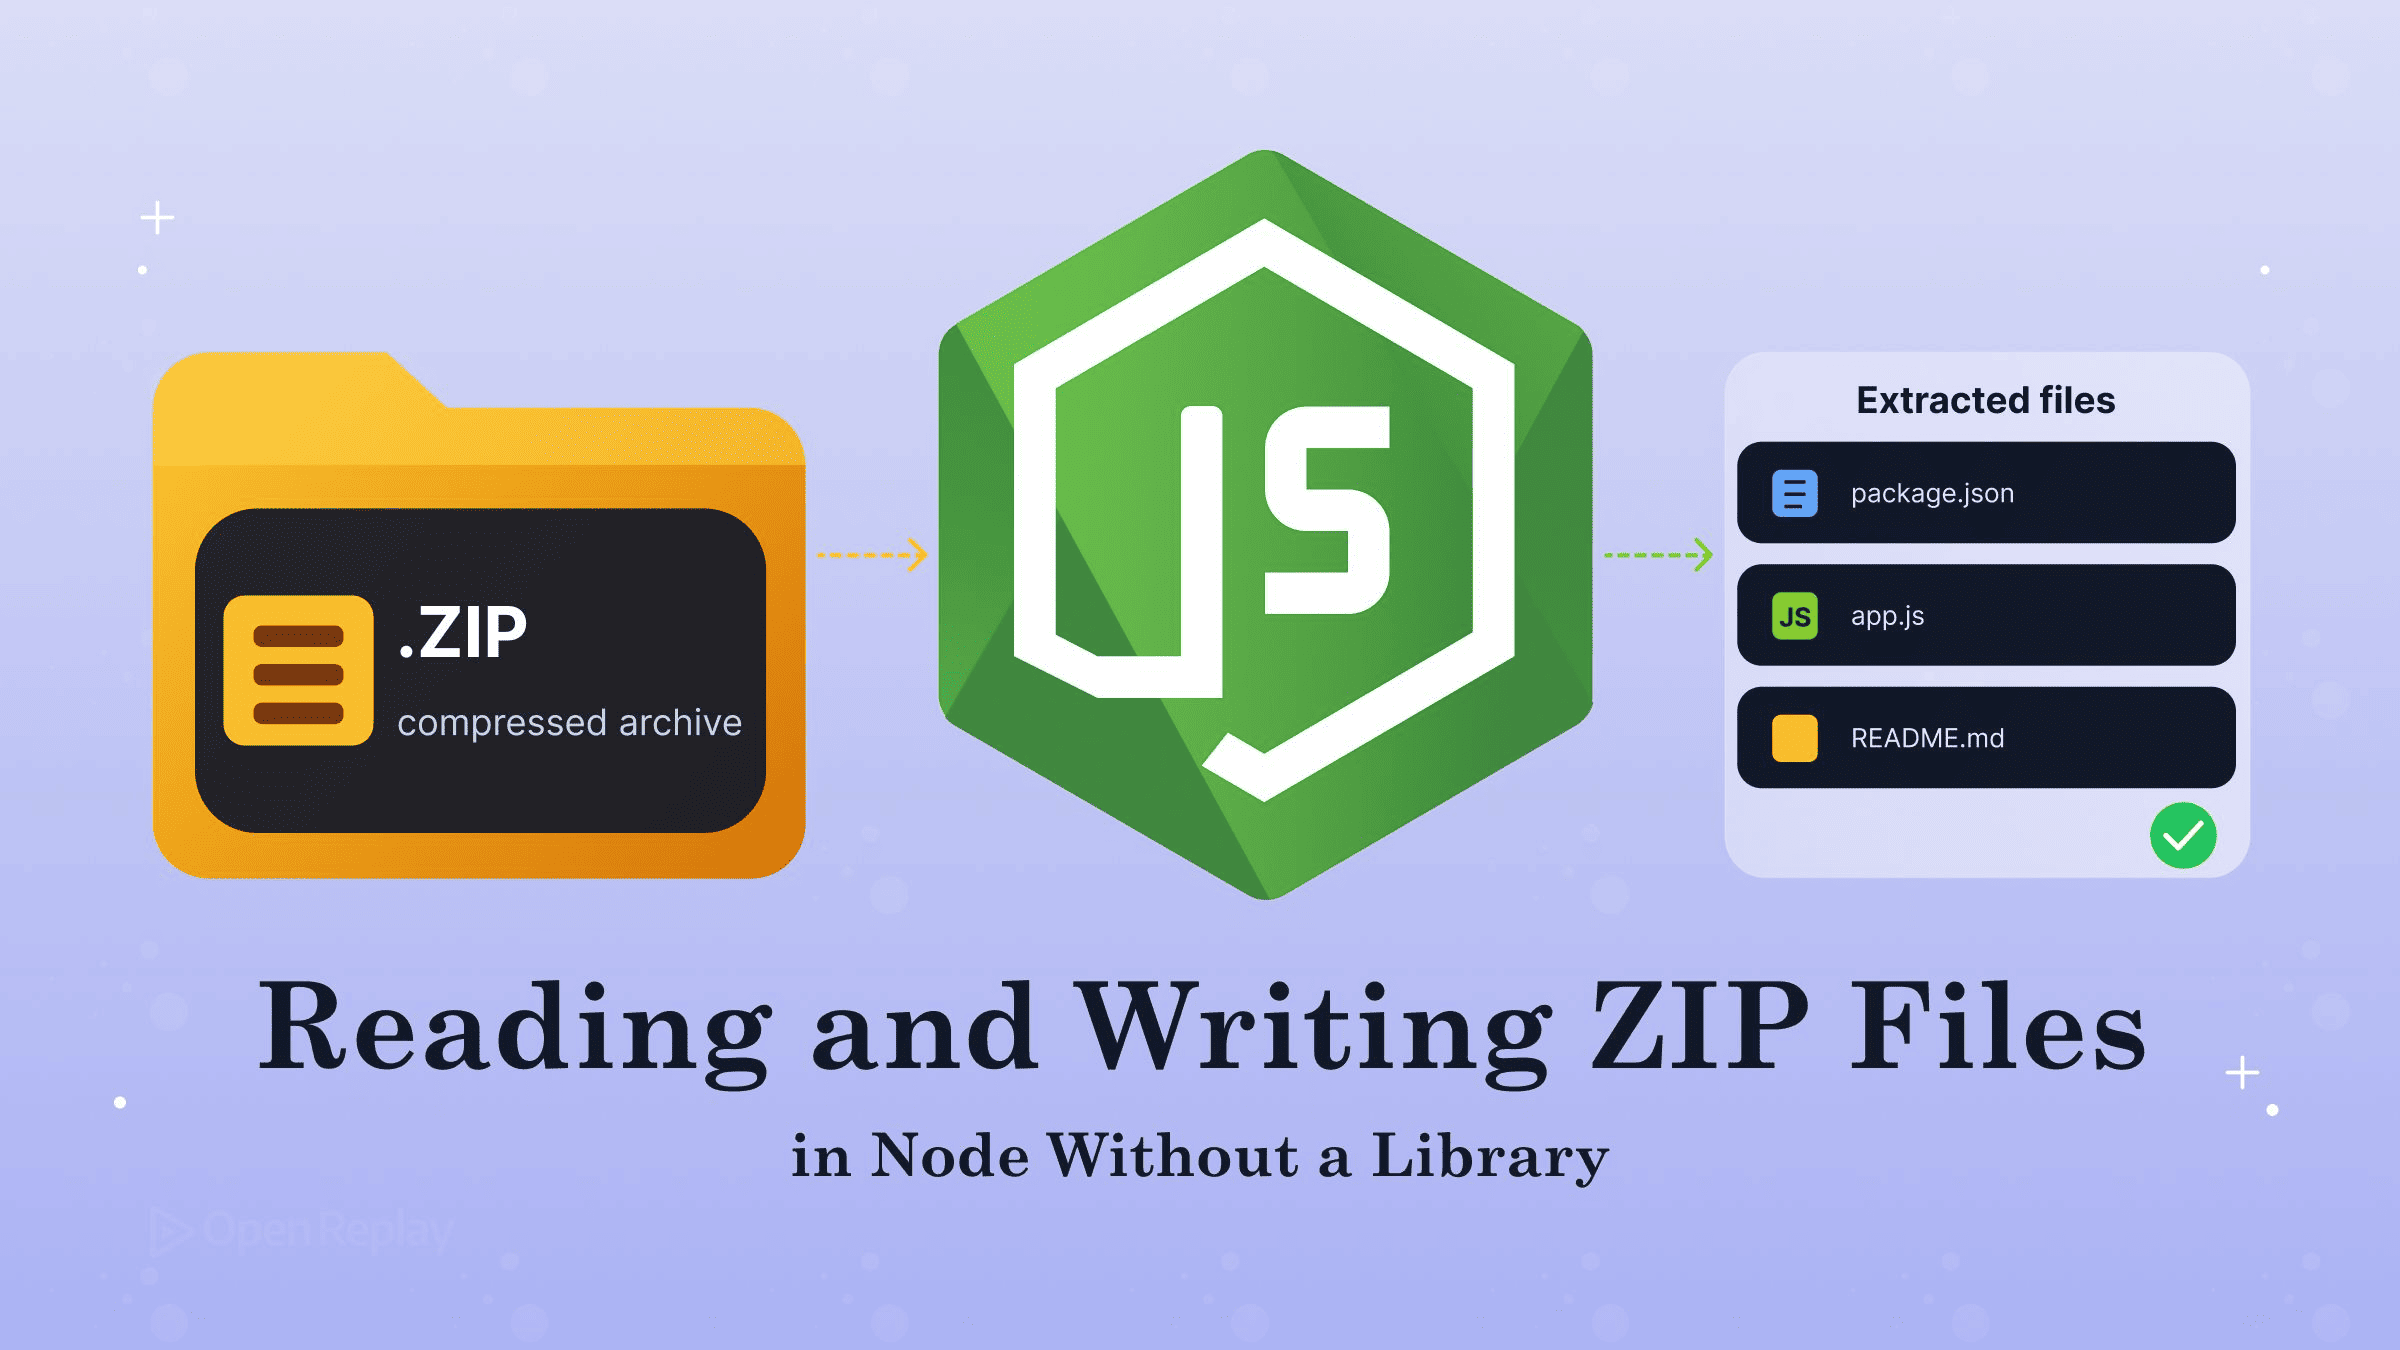
A partir de Node.js 26.8.0, el módulo integrado node:zlib puede leer y escribir archivos ZIP por sí solo, por lo que adm-zip, archiver y yauzl dejan de ser necesarios. La API es experimental.
La mayoría de los proyectos de Node que aceptan subidas de archivos o generan artefactos de release incluyen al menos un paquete para ZIP, y a menudo dos: yauzl para lectura y archiver para escritura. Ambos son código de terceros que procesa entrada binaria no confiable.
La funcionalidad se publicó en la versión 26.8.0 de Node.js el 26 de agosto de 2026, a través del PR #64339. La API de archivos ZIP es experimental. La primera llamada a cualquiera de sus partes emite una advertencia de funcionalidad experimental, mientras que importar node:zlib por sí solo no la emite. Hasta el momento, ninguna versión de Node 24 LTS la incluye: las clases ZIP no aparecen en los changelogs de la rama 24.x hasta la 24.21.0. Esto sigue el mismo patrón que otras API integradas de Node.js que sustituyen a paquetes de npm. La API es nueva y sigue evolucionando, así que consulta las firmas exactas en la documentación de node:zlib antes de pasar a producción.
Puntos clave
- Node.js 26.8.0 añadió compatibilidad experimental para leer y escribir archivos ZIP en
node:zlibmedianteZipFile,ZipBuffer,ZipEntryycreateZipArchive(). ZipEntry.content()carga un miembro completo en memoria, mientras quecontentIterator()lo transmite en streaming como fragmentos de Buffer.setMaxZipContentSize()establece el límite predeterminado para las lecturas en búfer, comocontent(). No limitacontentIterator(), que acepta su propia opciónmaxSizeen cada llamada.- La API de ZIP no rechaza nombres de entrada que contengan
../ni rutas absolutas, por lo que todo extractor necesita su propia comprobación contra zip-slip. - En Node 24 LTS, sigue usando yauzl para lectura y archiver para escritura.
| Paquete | Función | Sustituto integrado |
|---|---|---|
| adm-zip | Leer/escribir archivos completos en memoria | ZipBuffer, ZipFile, createZipArchive() |
| yauzl | Lectura en streaming | ZipFile + contentIterator() |
| archiver | Escritura en streaming | ZipEntry.create()/createStream() + createZipArchive() |
¿Cómo se lee un archivo ZIP en Node.js con ZipFile?
Para leer un archivo ZIP almacenado en disco en Node.js, ábrelo con ZipFile.open(), recorre sus entradas y llama a content() sobre el miembro que necesites. ZipFile trabaja mediante un descriptor de archivo: salta directamente al miembro solicitado, lo lee del disco solo cuando es necesario y no conserva su contenido después. ZipBuffer cumple la misma función para un archivo que ya tienes en memoria, como una subida almacenada en un Buffer, y lee desde esa memoria sin copiarla. ZipEntry representa un único miembro.
// Requires Node 26.8.0+ (experimental)
import { ZipFile } from 'node:zlib';

const zip = await ZipFile.open('upload.zip');
try {
  for await (const entry of zip.values()) {
    console.log(entry.name, entry.size);
  }
  if (zip.has('README.md')) {
    const readme = await zip.get('README.md');
    const buf = await readme.content({ maxSize: 1024 * 1024 });
    console.log(buf.toString('utf8'));
  }
} finally {
  await zip.close();
}
zip.get() se rechaza con ERR_ZIP_ENTRY_NOT_FOUND cuando el archivo no contiene ningún miembro con ese nombre, por eso el ejemplo comprueba primero zip.has(). zipFile.values() devuelve un iterador en el que cada elemento es una Promise que se resuelve en un ZipEntry. Por eso aquí encaja for await. Cada entrada expone name y size, que es el tamaño sin comprimir en bytes. Las llamadas asíncronas también tienen versiones síncronas (openSync(), contentSync(), valuesSync()). Las excepciones son las API de streaming: contentIterator() y ZipEntry.createStream() no tienen equivalente síncrono.
Streaming de archivos grandes con contentIterator()
Para leer miembros ZIP de gran tamaño en Node.js, usa contentIterator(). Este método entrega el contenido descomprimido como una serie de fragmentos de Buffer, de modo que el miembro completo nunca tiene que residir en memoria de una sola vez. Como es un iterable asíncrono, puedes pasarlo directamente a pipeline(). El modelo basado en pull es el mismo que se explica en cómo funcionan los streams para desarrolladores web.
// Requires Node 26.8.0+ (experimental)
import { ZipFile, setMaxZipContentSize } from 'node:zlib';
import { createWriteStream } from 'node:fs';
import { mkdir } from 'node:fs/promises';
import path from 'node:path';
import { pipeline } from 'node:stream/promises';
import { safeDestination } from './safe-destination.js';

setMaxZipContentSize(32 * 1024 * 1024); // caps buffered content() reads
const MAX_ENTRY_BYTES = 2 * 1024 ** 3;

const zip = await ZipFile.open('large.zip');
try {
  for await (const entry of zip.values()) {
    if (entry.isSymlink) continue; // don't recreate links from untrusted archives
    const target = safeDestination('out', entry.name);
    if (entry.name.endsWith('/')) {
      await mkdir(target, { recursive: true });
      continue;
    }
    if (entry.size > MAX_ENTRY_BYTES) throw new Error(`Too large: ${entry.name}`);
    await mkdir(path.dirname(target), { recursive: true });
    await pipeline(entry.contentIterator(), createWriteStream(target));
  }
} finally {
  await zip.close();
}
setMaxZipContentSize() protege contra las bombas zip: una subida que ocupa poco comprimida puede expandirse hasta un tamaño enorme. Establece el límite máximo predeterminado, a nivel de todo el módulo, para las lecturas en búfer como content(). La documentación indica que contentIterator() no está sujeto a ese valor predeterminado, porque el streaming nunca realiza una única asignación de memoria de gran tamaño. La opción maxSize de content(), que se pasa en cada llamada, rechaza cualquier entrada cuyo tamaño declarado sin comprimir supere el valor indicado. Si la omites, content() utiliza el límite global del módulo obtenido de getMaxZipContentSize(). contentIterator() acepta su propia opción maxSize, que por defecto no tiene límite.
Las lecturas en streaming cuentan con una salvaguarda independiente. Un PR posterior de refuerzo de seguridad explica que el decodificador en streaming nunca produce más bytes que el tamaño declarado sin comprimir del miembro. Si los datos intentan descomprimirse por encima de ese tamaño, lanza ERR_ZIP_ENTRY_CORRUPT de inmediato. Por eso el bucle anterior comprueba entry.size antes de empezar el streaming.
¿Cómo se crea un archivo ZIP a partir de una carpeta?
Para crear un archivo ZIP en Node.js, genera un ZipEntry por cada archivo y pasa la lista a createZipArchive(), que convierte esas entradas en un stream legible con los bytes del archivo ZIP. Después, redirige ese stream a un archivo. Primero, recopila los archivos con fs.readdir y su opción recursive:
// collect-files.js
import { readdir, lstat } from 'node:fs/promises';
import path from 'node:path';

export async function collectFiles(root) {
  const files = [];
  for (const rel of await readdir(root, { recursive: true })) {
    const abs = path.join(root, rel);
    if (!(await lstat(abs)).isFile()) continue; // skips dirs and symlinks
    files.push({ abs, name: rel.split(path.sep).join('/') });
  }
  return files.sort((a, b) => a.name.localeCompare(b.name));
}
Como la función usa lstat, omite los enlaces simbólicos en lugar de seguirlos. A continuación, serializa las entradas:
// Requires Node 26.8.0+ (experimental)
import { readFile } from 'node:fs/promises';
import { createWriteStream } from 'node:fs';
import { pipeline } from 'node:stream/promises';
import { ZipEntry, createZipArchive } from 'node:zlib';
import { collectFiles } from './collect-files.js';

const entries = [];
for (const f of await collectFiles('dist')) {
  entries.push(await ZipEntry.create(f.name, await readFile(f.abs)));
}
const archive = await createZipArchive(entries);
await pipeline(archive, createWriteStream('release.zip'));
ZipEntry.create() recibe primero el nombre del archivo y después los datos. La versión síncrona está documentada como zlib.ZipEntry.createSync(filename, data, options). Este ejemplo carga cada archivo en un búfer antes de añadirlo. Para archivos grandes, usa ZipEntry.createStream() en su lugar. Este método comprime el origen mientras createZipArchive() escribe el archivo ZIP, de modo que el archivo completo nunca tiene que mantenerse en memoria. Una entrada en streaming solo funciona una vez: después de que createZipArchive() la haya escrito, su contenido queda consumido y no puede volver a leerse.
Carpetas anidadas y protección contra zip-slip
Las rutas dentro de un archivo ZIP usan barras normales (/), independientemente del sistema operativo que las haya creado. La especificación del formato de archivo ZIP lo exige en su apartado sobre nombres de archivo (4.4.17). Por ello, collectFiles convierte path.sep en /, de modo que una ruta de Windows como assets\img\logo.png se almacena como assets/img/logo.png. Los nombres de entrada que terminan en / son directorios.
Zip-slip es un ataque de path traversal (recorrido de rutas) en el que un archivo malicioso contiene una entrada con un nombre como ../../etc/passwd, y un extractor ingenuo la escribe fuera del directorio de destino. La API integrada transmite esos nombres exactamente tal como aparecen en el archivo, sin sanearlos y sin generar errores, por lo que la comprobación es responsabilidad tuya. Resuelve cada nombre respecto al directorio de destino y rechaza cualquier ruta que quede fuera de él:
// safe-destination.js
import path from 'node:path';

export function safeDestination(destDir, entryName) {
  if (entryName.includes('\0')) throw new Error(`NUL byte in ${entryName}`);
  const root = path.resolve(destDir);
  const target = path.resolve(root, entryName);
  if (target !== root && !target.startsWith(root + path.sep)) {
    throw new Error(`Blocked entry outside ${root}: ${entryName}`);
  }
  return target;
}
La función rechaza tanto el recorrido mediante ../ como los nombres absolutos, como /etc/passwd. Llámala sobre cada entry.name antes de escribir nada. Las entradas de enlaces simbólicos requieren la misma precaución. La documentación advierte que cualquier extractor que respete una entrada de enlace simbólico creará un enlace real en el disco, por lo que no puedes confiar en el destino al que apunta. La solución más sencilla es omitir las entradas en las que entry.isSymlink sea true, como hace el bucle de streaming anterior.
En versiones antiguas de Node o LTS: mantén yauzl y archiver
Si usas Node 24 LTS o una versión anterior, mantén yauzl para lectura y archiver para escritura. Las nuevas funcionalidades de la línea Current pueden portarse (backport) a una línea LTS activa, así que revisa los changelogs de la rama 24.x antes de eliminar los paquetes. Hasta que la API esté disponible en la versión de Node que usas en producción, conserva los paquetes. Una comprobación en tiempo de ejecución permite que las herramientas compartidas elijan la ruta adecuada:
const [major, minor] = process.versions.node.split('.').map(Number);
const hasNativeZip = major > 26 || (major === 26 && minor >= 8);
Este es el código de archiver que sustituye la API integrada. Archiver 8 eliminó la exportación por defecto, por lo que se usa la clase con nombre ZipArchive; en archiver 7 y versiones anteriores, escribe import archiver from 'archiver' y archiver('zip') en su lugar:
import { ZipArchive } from 'archiver'; // archiver 8+
import { createWriteStream } from 'node:fs';
import { once } from 'node:events';

const output = createWriteStream('release.zip');
const closed = once(output, 'close');
const archive = new ZipArchive();
archive.pipe(output);
archive.directory('dist/', false);
await archive.finalize();
await closed; // release.zip is fully written and closed
finalize() se resuelve cuando archiver ha terminado de producir datos, no cuando el archivo se ha volcado a disco y cerrado. Esperar al evento close del stream de salida garantiza que se pueda leer release.zip inmediatamente después.
Conclusión
En Node 26.8.0 o posterior, node:zlib cubre las tareas habituales con archivos ZIP: lectura con ZipFile, streaming de miembros grandes con contentIterator() y escritura con ZipEntry y createZipArchive(). Esto abarca lo que hacían adm-zip, archiver y yauzl. Como la API es experimental, fija tu versión de Node, mantén la protección contra zip-slip y los límites de tamaño, y vuelve a revisar la documentación de node:zlib en cada actualización. Un buen primer paso es sustituir una única ruta de lectura, como la extracción de subidas, detrás de la comprobación hasNativeZip. Conserva el paquete como alternativa hasta que tu línea de producción admita la API.
Preguntas frecuentes
¿Qué ocurre si dos entradas comparten el mismo nombre cuando llamo a createZipArchive() en Node?
createZipArchive() escribe ambas entradas. Las escribe en el orden en que las recibe y no comprueba si hay nombres repetidos, por lo que el archivo acaba con duplicados, y la mayoría de las herramientas de extracción conservan la última copia. Los métodos add() de ZipBuffer y ZipFile funcionan de otra manera: sustituyen una entrada existente con el mismo nombre. Si tu lista de archivos puede contener rutas repetidas, elimina los duplicados antes de serializar.
¿Puede node:zlib escribir archivos ZIP de más de 4 GB?
Sí. createZipArchive() pasa automáticamente a estructuras Zip64 en cuanto el número de entradas, o cualquier desplazamiento o tamaño, excede la capacidad de los campos originales de 16 y 32 bits del formato ZIP. Esto incluye miembros o archivos de más de 4 GB y archivos con más de 65.535 entradas. No necesitas ninguna opción para ello, y ZipBuffer.toBuffer() cambia a Zip64 de la misma forma cuando serializa las entradas.
¿Qué códigos de error debo gestionar al leer entradas ZIP con node:zlib?
Gestiona ERR_ZIP_ENTRY_TOO_LARGE, que se produce cuando el tamaño declarado de una entrada supera maxSize, y ERR_ZIP_ENTRY_CORRUPT, que se produce cuando la suma de comprobación CRC-32 del contenido es incorrecta o su longitud difiere del tamaño declarado. Solicitar un nombre que el archivo no contiene genera ERR_ZIP_ENTRY_NOT_FOUND (ZipFile.get() se rechaza con este error). Tras el refuerzo de seguridad del PR 65016, los archivos cuyas cabeceras locales y centrales no coinciden se rechazan con ERR_ZIP_INVALID_ARCHIVE.
¿Qué métodos de compresión utiliza la API ZIP integrada de Node?
La documentación de node:zlib indica deflate y Zstandard como métodos de compresión para las entradas comprimidas. Las entradas también pueden almacenarse sin comprimir. Cada ZipEntry tiene una propiedad booleana compressed: es true cuando se ha utilizado cualquiera de los dos métodos y false cuando el contenido se ha almacenado sin compresión. La documentación describe esta lista como vigente y la API es experimental, así que consulta la documentación correspondiente a tu versión de Node.
Gain Debugging Superpowers
Unleash the power of session replay to reproduce bugs, track slowdowns and uncover frustrations in your app. Get complete visibility into your frontend with OpenReplay — the most advanced open-source session replay tool for developers.
Star on GitHub12k