Comprobaciones automatizadas que reducen la carga de tu revisión de código
Automatiza la revisión de código con OpenAPI, dependency-cruiser y pruebas de mutación de Stryker. Configura CI para detectar errores mecánicos y reducir la carga de revisión.

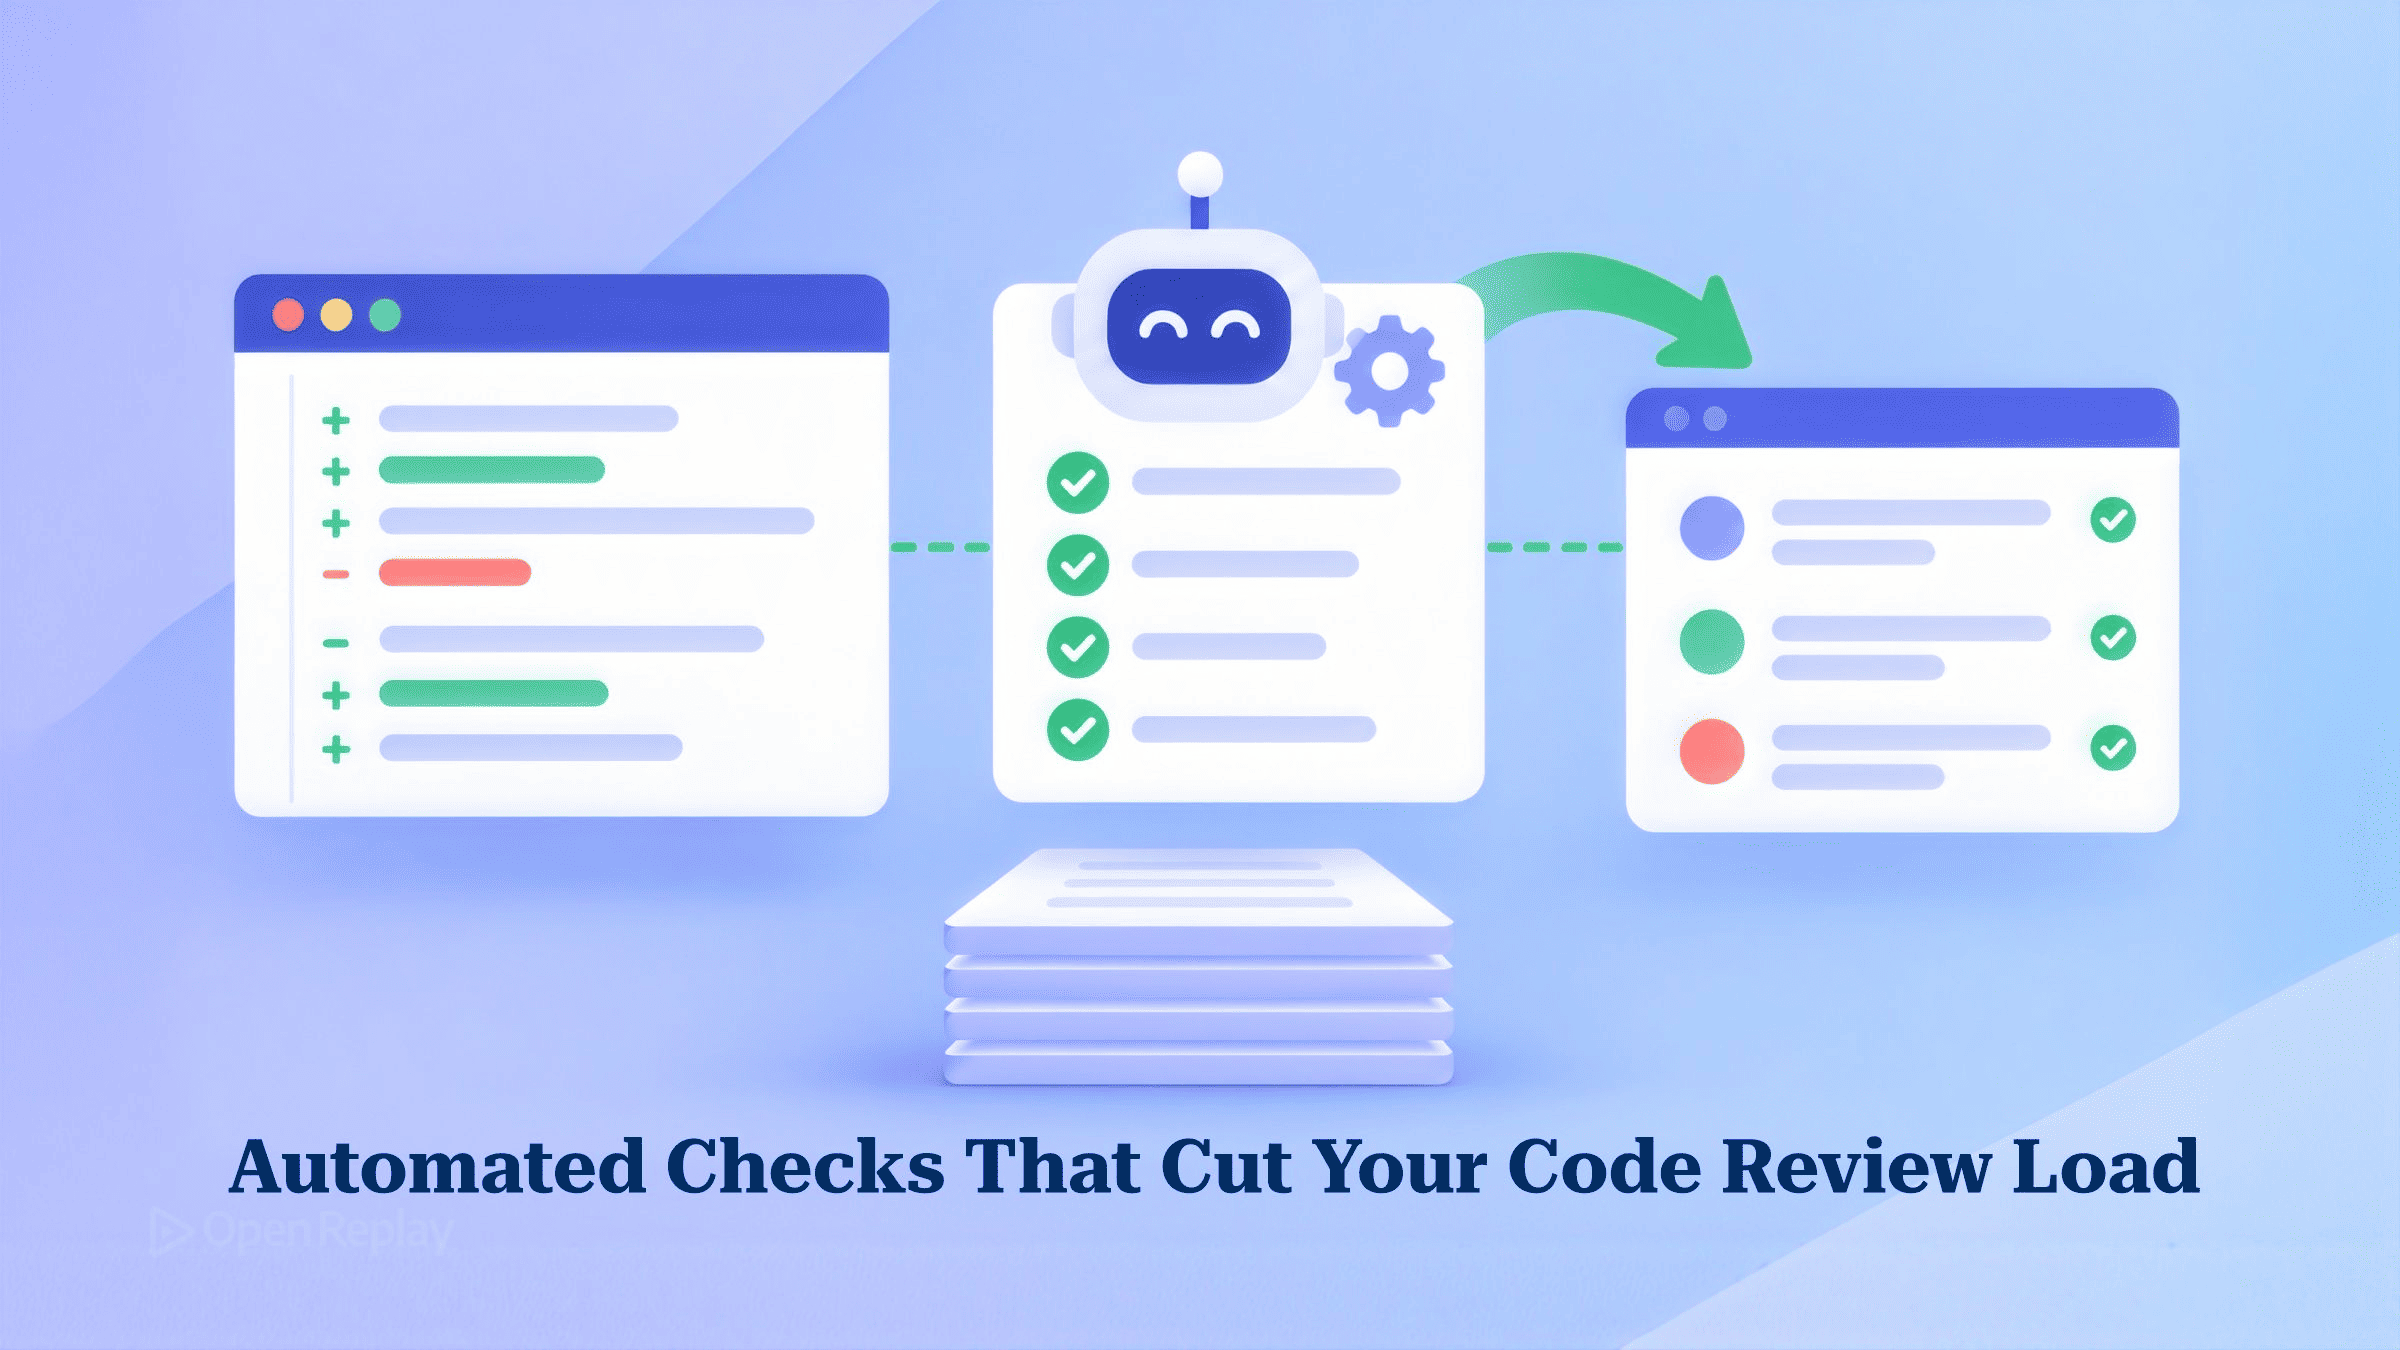
La revisión de código automatizada, en su forma determinista, es un conjunto de comprobaciones de CI que hacen fallar un pull request cuando el código incumple una regla. Así, los revisores dedican su tiempo al diseño, la intención y el encaje con el producto, en lugar de a los errores mecánicos.
Los agentes de programación abren pull requests más rápido de lo que nadie puede leerlos línea por línea. Si eres líder técnico, acabas aprobando diffs sin revisarlos de verdad o convirtiéndote en el cuello de botella, y ninguna de las dos situaciones es sostenible.
La solución es que las máquinas detecten los problemas mecánicos y reservar la atención humana para todo lo demás. Estas comprobaciones merecen la pena independientemente de quién haya escrito el código. Este artículo cubre tres de ellas, añade dos extras de bajo coste, muestra cómo integrarlo todo en CI y termina con lo que ninguna de ellas puede detectar. Seguramente ya ejecutas linting, formateo y tests unitarios. Si no es así, empieza con esta configuración de ESLint y Prettier.
| Comprobación | Qué detecta | Qué ya no tiene que revisar el revisor | Herramienta |
|---|---|---|---|
| Generación de código a partir del contrato | Campos que la API nunca devuelve | Si cada campo de la respuesta existe | Hey API openapi-ts |
| Límites entre capas | Imports que cruzan capas arquitectónicas | Si cada import va en la dirección correcta | dependency-cruiser |
| Mutation testing | Tests que ejecutan código sin hacer aserciones sobre él | Si cada test nuevo comprueba realmente el comportamiento | Stryker |
| Código muerto | Archivos, exports y dependencias sin usar | Si algo ha quedado huérfano | Knip |
| Duplicación | Bloques copiados y pegados | Si esta lógica ya existe | jscpd |
Conclusiones clave
- Si el cliente de TypeScript se genera a partir de una especificación OpenAPI, leer un campo que la API nunca devuelve, como
user.fullName, es un error de compilación en lugar de un comentario de revisión. - Una regla
forbiddende dependency-cruiser con severidaderrorhace fallar la CI cuando un servicio importa un componente. Ejecútalo con el reportererr-longy elcommentde la regla aparecerá junto a cada infracción, indicando al desarrollador dónde debería ir el import. - La cobertura de líneas demuestra que el código se ejecutó. El mutation testing demuestra si algún test falla cuando ese código se rompe deliberadamente.
- Trata la puntuación de mutación como un detector y deja sin definir
thresholds.breakde Stryker, porque los mutantes equivalentes hacen que un umbral estricto resulte engañoso. - Introduce las reglas nuevas como advertencias sobre los archivos modificados. Convierte en errores las que detecten bugs reales y haz obligatorio un job solo cuando se haya estabilizado.
Genera tu cliente de API a partir de la especificación OpenAPI
Si el cliente de TypeScript se genera a partir de una especificación OpenAPI, leer un campo que la API nunca devuelve, como user.fullName, es un error de compilación en lugar de un comentario de revisión. Una interfaz escrita a mano puede desincronizarse del backend sin que nadie se dé cuenta. Una generada, no.
Un tipo escrito a mano compila incluso cuando es incorrecto:
// Hand-written: compiles, but the backend never sends fullName
interface User { id: string; fullName: string }
declare const user: User;

const label = user.fullName;
Si, en cambio, generas el tipo a partir de la especificación, la misma lectura falla en tiempo de compilación:
// Generated from the spec
type User = { id: string; firstName: string; lastName: string };
declare const user: User;

const label = user.fullName;
// error TS2339: Property 'fullName' does not exist on type 'User'.
const fixed = `${user.firstName} ${user.lastName}`;
Herramientas como Hey API openapi-ts leen un documento OpenAPI y generan tipos y un cliente. Una vez generado el cliente, revisa la especificación en su lugar. Trata el código generado como un artefacto de build: no lo edites a mano y no lo revises línea por línea.
Los tipos desaparecen en tiempo de compilación, así que añade un validador en tiempo de ejecución, como Zod, para las respuestas en las que no te puedas permitir confiar a ciegas. Nada de esto funciona sin una especificación de referencia que el backend mantenga actualizada. La configuración completa se explica en cómo crear clientes de API con tipado seguro con OpenAPI y TypeScript.
Aplica límites entre capas con dependency-cruiser
dependency-cruiser comprueba cada import de un proyecto JavaScript o TypeScript con las reglas forbidden de su archivo de configuración. Las infracciones se muestran con un formato muy parecido a la salida de ESLint, y cualquier infracción de una regla con severidad error hace que el comando termine con un código distinto de cero, lo que hace fallar el job de CI. Eso elimina de la lista del revisor la pregunta «¿de verdad este servicio debería importar un componente?».
npm install --save-dev dependency-cruiser
npx dependency-cruiser --init
--init genera .dependency-cruiser.js, o .dependency-cruiser.cjs cuando package.json define "type": "module". El archivo que crea incluye un conjunto de reglas por defecto. Estas señalan ciclos de imports, módulos huérfanos, paquetes que importas pero que nunca se declararon en package.json y código de producción que incorpora dependencias de desarrollo. Añade tu regla de capas junto a ellas:
module.exports = {
  forbidden: [
    {
      name: "services-not-to-components",
      comment:
        "Services must not import UI. Move shared types to src/types or next to the service.",
      severity: "error",
      from: { path: "^src/services" },
      to: { path: "^src/components" },
    },
  ],
};
Redacta el comment como instrucciones, no como una etiqueta. El reporter por defecto, err, lo omite, pero el reporter err-long lo muestra con cada infracción. Así, el desarrollador o el agente que provocó el fallo lee la solución, no solo el error:
npx dependency-cruiser --output-type err-long srceslint-plugin-boundaries hace lo mismo dentro de ESLint, si prefieres mantener esto en tu linter. oxlint no tiene ninguna regla integrada para capas arquitectónicas, pero su regla no-restricted-imports puede bloquear los imports que coincidan con un patrón.
Usa mutation testing para comprobar si los tests detectan fallos
El mutation testing evalúa la calidad de los tests: la cobertura de líneas demuestra que el código se ejecutó, mientras que el mutation testing demuestra si algún test falla cuando ese código se modifica deliberadamente. Una suite puede alcanzar el 100 % de cobertura y, aun así, no comprobar casi nada; el mutation testing es la forma de descubrirlo.
Stryker introduce pequeños cambios en tu código fuente, y cada versión modificada se denomina mutante. Después ejecuta tus tests contra cada mutante. Un mutante queda eliminado cuando algún test falla contra él, y sobrevive cuando toda la suite sigue pasando.
El propio ejemplo de Stryker muta return user.age >= 18 de cuatro formas: > 18, < 18, return false y return true.
export function isUserOldEnough(user: { age: number }): boolean {
  return user.age >= 18;
}

// Weak: 100% line coverage, two survivors
it("lets adults in", () => {
  expect(isUserOldEnough({ age: 25 })).toBe(true);
});

// Added: boundary cases
it("lets in someone who is exactly 18", () => {
  expect(isUserOldEnough({ age: 18 })).toBe(true);
});
it("keeps out someone who is 17", () => {
  expect(isUserOldEnough({ age: 17 })).toBe(false);
});
Un test que solo comprueba a alguien de 25 años pasa tanto contra el mutante > 18 como contra el mutante return true, así que ambos sobreviven aunque la cobertura de líneas sea del 100 %. Ese test solo elimina < 18 y return false. El caso de 18 años elimina > 18, y el de 17 años elimina return true. Con los tres tests, todos los mutantes quedan eliminados.
Los mutantes supervivientes suelen deberse a unos pocos patrones reconocibles de tests débiles:
- Comprobar que se llamó a una función sin comprobar con qué argumentos.
- Comprobar que un resultado existe, o cuál es su longitud, sin examinar su contenido.
- Hacer commit de un snapshot que nadie ha contrastado con la salida esperada.
- Calcular el valor esperado con la misma lógica que el código bajo prueba.
- Comprobar lo que devuelve un mock en lugar de lo que el código hace con ello.
Un mutante superviviente señala un comportamiento que ningún test fija. Sin embargo, algunos mutantes son equivalentes al código original, por lo que la puntuación de mutación funciona mejor como detector que como umbral de aprobado/suspenso. Además, un umbral estricto premia los tests escritos para eliminar mutantes en lugar de para comprobar comportamiento. La opción thresholds.break de Stryker hace fallar el build por debajo de una puntuación determinada. Su valor por defecto es null, y deberías dejarlo así. En su lugar, revisa los supervivientes en el PR.
Para que las ejecuciones sean cortas, muta solo los archivos que ha modificado un PR con npx stryker run --mutate <comma-separated files>. El modo incremental (--incremental) guarda los resultados de la última ejecución en reports/stryker-incremental.json y reutiliza lo que puede, pero en CI solo ahorra tiempo si el archivo se cachea entre ejecuciones. Instala también el plugin de test runner correspondiente a tu framework (@stryker-mutator/vitest-runner o @stryker-mutator/jest-runner). Sin él, Stryker recurre a su command runner, que ejecuta la suite completa para cada mutante. Para la parte de criterio en la calidad de los tests, es decir, decidir qué merece un test en primer lugar, consulta nuestro artículo sobre testing en la era de la IA.
Ejecuta cada comprobación como un job de CI obligatorio e independiente
Una comprobación que se puede omitir no se está aplicando. Asigna a cada comprobación su propio job para que un fallo sea evidente de un vistazo y, después, marca cada job como status check obligatorio en tu protección de ramas o ruleset. Si GitHub Actions es nuevo para ti, empieza con esta guía práctica de GitHub Actions.
on: pull_request
jobs:
  lint:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-node@v7
        with: { node-version: 22, cache: npm }
      - run: npm ci
      - run: npx eslint . && npx prettier --check .
      - run: npx dependency-cruiser --output-type err-long src
  typecheck:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-node@v7
        with: { node-version: 22, cache: npm }
      - run: npm ci
      - run: npx tsc --noEmit
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-node@v7
        with: { node-version: 22, cache: npm }
      - run: npm ci
      - run: npm test
  mutation:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
        with: { fetch-depth: 0 }
      - uses: actions/setup-node@v7
        with: { node-version: 22, cache: npm }
      - run: npm ci
      - name: Mutate changed files only
        run: |
          FILES=$(git diff --name-only --diff-filter=AMR "origin/${{ github.base_ref }}...HEAD" -- ':(glob)src/**/*.ts' ':(glob)src/**/*.tsx' \
            | grep -vE '\.(test|spec)\.tsx?$' | paste -sd, -)
          if [ -z "$FILES" ]; then echo "No source changes"; exit 0; fi
          npx stryker run --mutate "$FILES"
  build:
    needs: [lint, typecheck, test, mutation]
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-node@v7
        with: { node-version: 22, cache: npm }
      - run: npm ci
      - run: npm run build
El job de mutación descarga el historial completo (fetch-depth: 0) para poder calcular el diff respecto a la rama base. Después pasa a Stryker únicamente los archivos fuente modificados, excluyendo los archivos de test.
Introduce las reglas nuevas de forma gradual:
- Añade cada regla nueva como advertencia. En dependency-cruiser,
severity: "warn"informa de las infracciones pero no hace fallar el job. Soloerrorlo hace. - Ejecuta las comprobaciones solo sobre los archivos modificados.
- Convierte una advertencia en error cuando detecte un bug real, y elimina las reglas que solo generen ruido.
- Haz obligatorio un job solo cuando se haya estabilizado.
Merece la pena añadir otras dos comprobaciones automatizadas de bajo coste: Knip para el código muerto y jscpd para la duplicación. Knip informa de los archivos que nada importa, los exports que nadie usa y los paquetes que ya no necesitas. jscpd señala bloques de código duplicados.
¿Qué no pueden decirte las comprobaciones automatizadas de revisión de código?
Las comprobaciones deterministas no pueden decirte si la funcionalidad es la adecuada, si una abstracción llegó demasiado pronto o si alguien del equipo entiende el código. Son cuestiones de criterio y requieren a una persona.
De un pull request que supera todas las comprobaciones deterministas solo se ha demostrado que está libre de los defectos que esas comprobaciones buscan. Para la parte humana de la revisión, consulta nuestro artículo sobre testing en la era de la IA.
Empieza por el contrato
Cada pregunta mecánica que delegas en una máquina devuelve tiempo de revisión humana para las preguntas que solo las personas pueden responder. Si solo vas a añadir una comprobación en este sprint, genera tu cliente de API a partir de la especificación, porque evita toda una clase de defectos antes de que nadie los escriba. Después, añade mutation testing sobre el diff del PR, como un job que solo emita advertencias, y revisa lo que sobrevive.
Preguntas frecuentes
¿Cómo añado reglas de dependency-cruiser a un código existente que ya tiene cientos de infracciones?
Registra las infracciones existentes como baseline y haz fallar la ejecución solo con las nuevas. Desde dependency-cruiser 18.3.0, la forma recomendada es la opción --baseline. Por defecto, escribe .dependency-cruiser-known-violations.json en la raíz del proyecto, y al ejecutar con --ignore-known se rebaja a ignore cada infracción incluida en ese archivo. Cualquier import nuevo que incumpla la misma regla seguirá fallando. Como la coincidencia no tiene en cuenta la severidad, cambiar la severidad de una regla mantiene sus entradas en el baseline.
¿Funciona el mutation testing de Stryker con Vitest?
Sí. StrykerJS añadió compatibilidad con Vitest en la versión 7.0 mediante el plugin @stryker-mutator/vitest-runner, y los proyectos con Jest usan @stryker-mutator/jest-runner. El runner de Vitest siempre utiliza el análisis de cobertura perTest e ignora cualquier valor de coverageAnalysis que configures. El modo Browser de Vitest no es compatible. Stryker ejecuta los tests en un único hilo por worker y, en su lugar, paraleliza mediante sus propios workers.
¿Qué es un mutante equivalente en mutation testing?
Un mutante equivalente modifica el código fuente sin cambiar lo que hace el programa, por lo que ningún test puede eliminarlo. Un ejemplo clásico es sustituir i < length por i != length en un bucle que cuenta de uno en uno desde cero: ambos se detienen en el mismo punto. Como los mutantes equivalentes siempre sobreviven, una puntuación de mutación del 100 % suele ser inalcanzable, y los supervivientes necesitan que una persona los revise.
¿Qué ocurre cuando Stryker se ejecuta sobre archivos modificados que no tienen tests?
Por defecto, Stryker se detiene con un error No tests found cuando su dry run inicial no ejecuta ningún test, lo que hace fallar un job de CI que solo muta el diff del PR. Desde StrykerJS 7.0, el flag --allowEmpty (o allowEmpty: true en el archivo de configuración) evita que eso sea un error. Los mutantes en código que ningún test ejecuta se notifican como sin cobertura, lo que señala directamente los tests que faltan.