Qu'est-ce que Jev ? Des décisions IA rapides sans génération de texte
Découvrez comment Jev AI transforme un état en décisions typées pour le routage et la classification, avec exemples d’API, tarifs, limites et conseils d’usage.

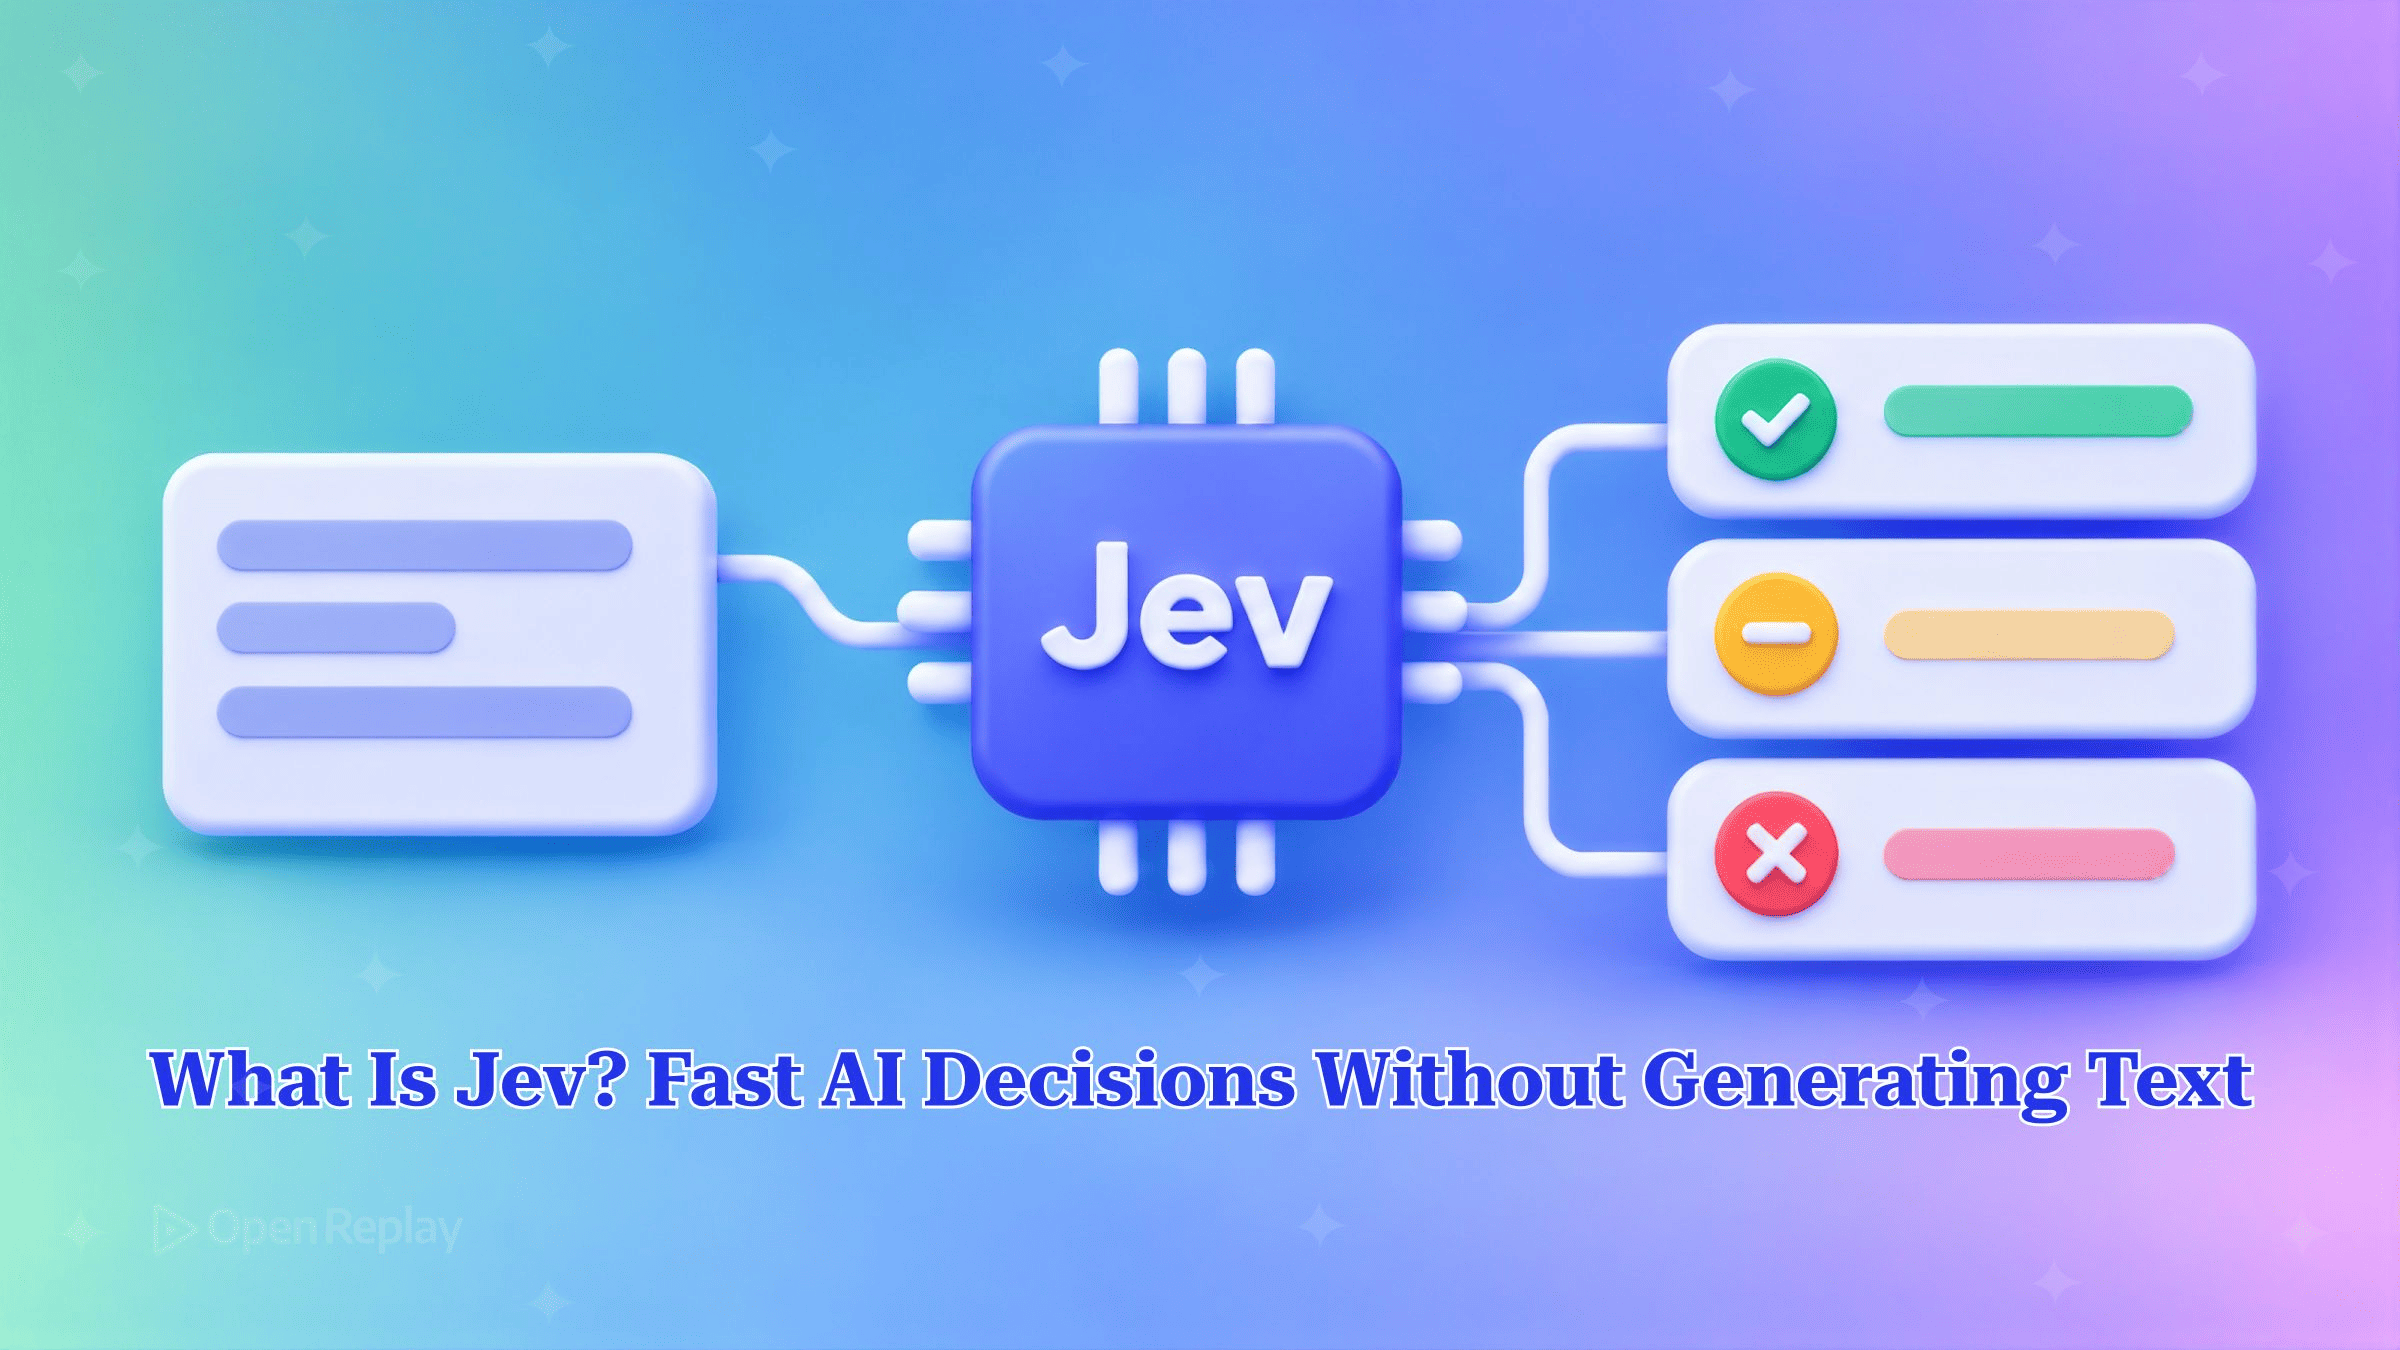
Jev est un modèle de décision développé par TypeSafe AI. Vous lui transmettez un état et un ensemble de questions typées, et il vous renvoie une réponse structurée, assortie de probabilités pour chaque question. Il ne génère pas de texte.
Si votre étape de routage repose sur une chat completion qui demande du JSON puis exécute json.loads dans un bloc try, vous en connaissez déjà les coûts : vous attendez les tokens générés, vous les payez, et de temps à autre la sortie ne respecte pas votre schéma. Cet article présente ce que renvoie Jev, à quoi ressemble une requête envoyée à l’endpoint de TypeSafe, et quelles étapes de décision confiées à un LLM il peut raisonnablement reprendre.
Points clés
- Jev est le premier des modèles System One de TypeSafe AI. Sorti le 15 septembre 2026, il répond à des questions typées par des valeurs structurées, et non par de la prose.
- Une requête Jev comporte trois champs obligatoires de premier niveau :
state,modeletquestions. La réponse contient un objetanswersindexé par les identifiants de vos questions, ainsi que la consommation de tokens dansusage. - Jev propose trois types de questions pour les décisions portant sur du texte. Choice sélectionne une option parmi 255 au maximum, Score positionne l’entrée sur une grille ordonnée de 2 à 10 niveaux, et Noul renvoie la probabilité que la réponse à une question fermée soit « oui ».
- TypeSafe facture Jev 0,042 $ par million de tokens en entrée, et les tokens de sortie sont gratuits.
- Les réponses de Jev appartiennent toujours à l’espace de réponses défini dans la requête. Cela élimine les erreurs de parsing et de schéma, mais ne garantit pas que les réponses soient justes.
Qu’est-ce que Jev AI ?
Jev est un modèle de TypeSafe AI qui prend des décisions là où un LLM classique produirait du texte. C’est le premier modèle d’une catégorie que TypeSafe appelle les modèles System One. Dans son annonce de lancement, TypeSafe le présente comme une nouvelle catégorie de modèles de pointe (frontier models) conçus pour prendre des décisions rapides et structurées, directement exploitables par un logiciel. Le nom fait référence au « Système 1 » de Kahneman, le mode de pensée rapide et intuitif. L’accès se fait via un programme d’accès anticipé.
Comment Jev transforme-t-il un état en réponses typées ?
Jev reçoit un state (texte ou JSON), un identifiant model et une map de questions, puis renvoie une réponse typée par question, chacune accompagnée de probabilités. Il évalue toutes les questions en parallèle. La documentation de Noul précise qu’ajouter des questions à une requête n’a quasiment aucun effet sur le temps de réponse. Vous choisissez vous-même les identifiants des questions, et ceux-ci ne sont pas transmis au modèle.
La référence de l’API définit trois types de questions pour les décisions portant sur du texte. Un quatrième type, box, localise une région dans une image et n’est disponible qu’en activant explicitement un en-tête expérimental.
| Type | À utiliser quand | Entrées | Champs renvoyés |
|---|---|---|---|
| Choice | La réponse est l’une de plusieurs options | instructions, ainsi que criteria associant chaque option (jusqu’à 255) à une description ou à null | choice, probabilities, confidence |
| Score | La réponse est un degré sur une échelle ordonnée | instructions, ainsi que criteria sous forme de tableau ordonné de 2 à 10 niveaux | score, legend (index du niveau vers son libellé), probabilities, confidence |
| Noul | La réponse est oui ou non | instructions, criteria facultatif avec des descriptions pour true/false | noul (probabilité entre 0 et 1) |
Une réponse Noul se résume à un nombre compris entre 0 et 1 et ne comporte pas de valeur de confiance distincte. Avec seulement deux issues possibles, une probabilité unique suffit à les décrire entièrement.
Exemple de requête et de réponse Noul
La requête ci-dessous pose deux questions fermées à propos d’un même message de support. Elle est envoyée à POST https://api.typesafe.ai/v1/systemone avec un bearer token. Les requêtes utilisent l’alias jev-latest, et la réponse indique quelle version précise a traité l’appel. La page des modèles indique la version vers laquelle l’alias pointe actuellement.
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My order arrived damaged and I want my money back.",
    "questions": {
      "wants_refund": {
        "type": "noul",
        "instructions": "Is the customer asking for a refund?"
      },
      "mentions_damage": {
        "type": "noul",
        "instructions": "Does the customer report a damaged item?",
        "criteria": {
          "true": "Describes the product as broken, damaged, or defective",
          "false": "No mention of physical damage"
        }
      }
    }
  }'
La réponse suit la structure ci-dessous. Les probabilités et le nombre de tokens sont donnés à titre indicatif et ne proviennent pas d’une sortie réelle. Les exemples réels figurant dans la documentation Noul de TypeSafe sont des sorties de jev-1.13.0.
{
  "model": "jev-1.14.0",
  "answers": {
    "wants_refund": { "type": "noul", "noul": 0.97 },
    "mentions_damage": { "type": "noul", "noul": 0.95 }
  },
  "usage": { "input_tokens": 120, "output_tokens": 2 }
}
output_tokens apparaît toujours dans usage, même si la sortie n’est pas facturée. N’importe quel client HTTP peut envoyer ce corps de requête. D’après le guide de démarrage rapide, TypeSafe fournit également un SDK Python (pip install typesafe-sdk, importé sous le nom typesafe_sdk et appelé via client.system_one), ainsi qu’un SDK JavaScript/TypeScript publié sous le nom @typesafe-ai/sdk.
Quand utiliser Jev pour le routage, la classification et la sélection d’outils ?
Jev convient aux étapes de décision dont l’espace de réponses est fini : router une requête, classer un ticket, évaluer un contenu selon une grille ou choisir un outil pour un agent. Si votre code extrait déjà un libellé ou un nombre d’une chat completion, cette étape est une bonne candidate.
Attribuer un message de support à une équipe relève d’une question Choice, puisque la réponse est exactement l’une de plusieurs options :
from typesafe_sdk import Choice, TypeSafeClient

TEAMS = {
    "billing": "Charges, invoices, refunds, payment methods",
    "technical": "Bugs, errors, outages, integration problems",
    "account": "Login, password resets, access, account settings",
}

def route_ticket(message: str) -> str:
    # TypeSafeClient reads TYPESAFE_API_KEY from the environment.
    with TypeSafeClient(model="jev-latest") as client:
        response = client.system_one(
            state=message,
            questions={
                "team": Choice(
                    instructions="Which team should handle this support message?",
                    criteria=TEAMS,
                ),
            },
        )
    answer = response.answers["team"]
    if answer.confidence < 0.8:
        return "triage"
    return answer.choice
La fonction renvoie l’une des trois clés du dictionnaire ou se rabat sur "triage" : il n’y a donc aucune chaîne à valider. Le seuil de 0,8 est une valeur provisoire à ajuster en fonction de votre propre trafic, et non une recommandation de TypeSafe. Pour les questions Noul, la documentation de TypeSafe suggère des seuils initiaux de 0,7 et 0,3, la zone intermédiaire étant transmise pour revue humaine.
Le routage est aussi le domaine où Jev se combine avec une passerelle de modèles comme 9router : la passerelle achemine les requêtes vers les modèles, tandis que Jev prend la décision de routage.
Ce que Jev ne sait pas faire
Jev ne génère pas de texte libre. Un pipeline qui l’utilise pour router ou classer un message a toujours besoin d’un modèle génératif pour rédiger la réponse. L’article de lancement présente l’abandon de la génération de texte comme un compromis délibéré au profit de la vitesse et du coût. Concrètement, Jev choisit l’équipe, l’outil ou la priorité, et un LLM rédige toujours l’e-mail, le résumé ou le code.
Quelles sont les limites et les réserves concernant Jev ?
Jev est un modèle propriétaire servi via l’API hébergée de TypeSafe. TypeSafe n’a pas publié ses poids. Les seuls leviers à votre disposition sont les instructions et les criteria que vous rédigez. Le service est en accès anticipé : attendez-vous donc à des évolutions de l’API, des versions du modèle et des tarifs. L’article de lancement précise d’ailleurs lui-même que les tarifs sont susceptibles de changer.
TypeSafe facture Jev 0,042 $ par million de tokens en entrée, la sortie étant gratuite, et annonce une latence de 70 à 500 millisecondes par appel. Les chiffres phares — 193,6 fois plus rapide et 444,6 fois moins cher — proviennent des évaluations de workflows réalisées par TypeSafe elle-même. Ces évaluations notent les modèles par rapport à la moyenne des réponses de deux grands LLM de référence, et TypeSafe présente ces gains comme la fourchette haute de ce que l’on peut espérer en pratique. Sur ce même benchmark, Jev obtient environ 68 %, ce qui le place au niveau des LLM de milieu de gamme. Ce chiffre mesure la concordance avec les modèles de référence, et non la précision par rapport à une vérité terrain annotée par des humains. Des tests indépendants ont donné des résultats inférieurs sur certaines tâches. Dans un benchmark public de détection de phishing portant sur 2 000 e-mails, Jev a obtenu 62,6 % sur une question unique « s’agit-il de phishing ? », contre 81,3 % pour Claude Haiku 4.5. Évaluez votre propre cas d’usage avant de remplacer quoi que ce soit.
Typé ne veut pas dire juste. L’espace de réponses contraint la sortie, ce qui supprime les erreurs de schéma, mais Jev peut tout de même choisir la mauvaise option avec un niveau de confiance élevé. Considérez ses probabilités comme des signaux à soumettre à des seuils, à journaliser et à relire.
Conclusion
Jev transforme une étape de décision en un appel de fonction typé : l’état et les questions entrent, les probabilités sortent, et il n’y a rien à parser. Il ne remplace pas votre modèle génératif. Il remplace les appels LLM dont la seule fonction est de produire un libellé. Pour aller plus loin, prenez un prompt de classification ou de routage existant, réécrivez-le sous forme de question Choice ou Noul, et exécutez les deux versions sur le même échantillon de trafic réel avant de vous fier à l’une ou à l’autre.
FAQ
Faut-il utiliser Noul ou Score pour des questions de degré, comme le niveau de compétence ou l'urgence ?
Utilisez Score. Noul renvoie uniquement la probabilité que la réponse soit oui : une valeur de 0,5 signifie donc que le modèle hésite, et non qu'un élément se situe à un niveau moyen. La documentation de TypeSafe l'illustre avec la question « Le candidat maîtrise-t-il bien Python ? ». Quatre CV ont obtenu des valeurs Noul de 0,03, 0,14, 0,81 et 0,92. Un Score à quatre niveaux a placé ces mêmes CV à 0,0, 1,0, 2,05 et 2,89, chacun sur un niveau défini par le développeur ou à proximité.
Comment gérer une décision comportant plus de 255 options dans une question Choice ?
Procédez en deux étapes. Une question Choice accepte au maximum 255 options. Pour des ensembles plus vastes, l'article de lancement de TypeSafe recommande d'évaluer d'abord chaque candidat indépendamment, puis d'exécuter une question Choice explicite sur les meilleurs d'entre eux. TypeSafe précise que cette approche est plus lente qu'un appel unique. Les descriptions des options faisant partie de la requête, elles sont également comptabilisées dans la limite de contexte de 64k tokens par requête.
Jev fonctionne-t-il avec le Vercel AI SDK ?
Oui. Vercel fournit le provider @ai-sdk/typesafe-ai, et Vercel AI Gateway référence Jev sous l'identifiant de modèle typesafe-ai/jev. Les appels passent par une fonction expérimentale d'AI SDK 7, dont le nom et la signature sont donc susceptibles d'évoluer. Le provider renomme Noul en 'boolean' et renvoie la réponse dans un champ probability au lieu de noul : une question copiée depuis la documentation de TypeSafe doit donc voir son type passer de 'noul' à 'boolean'. Choice et Score conservent leur nom.
Quelle quantité de données une requête Jev peut-elle contenir ?
Par défaut, une requête Jev doit respecter deux limites : 64k tokens pour l'état et l'ensemble des questions, et 32k tokens pour l'état et chaque question prise individuellement. Le nombre de questions envoyées n'est pas plafonné en tant que tel. L'envoi de l'en-tête TypeSafe-Danger-Zone-Long-Context avec la valeur true relève ces deux limites à 262k tokens sur Jev 1.13 et 1.14. TypeSafe indique que le mode contexte long est plus lent et moins précis qu'avec les limites par défaut : ne l'activez donc que pour les requêtes qui en ont réellement besoin.
Gain Debugging Superpowers
Unleash the power of session replay to reproduce bugs, track slowdowns and uncover frustrations in your app. Get complete visibility into your frontend with OpenReplay — the most advanced open-source session replay tool for developers.
Star on GitHub12k