O que é o Jev? Decisões rápidas de IA sem gerar texto
Veja como Jev AI transforma estados em decisões tipadas para roteamento e classificação, com exemplos de API, preços, limites e orientações de uso.

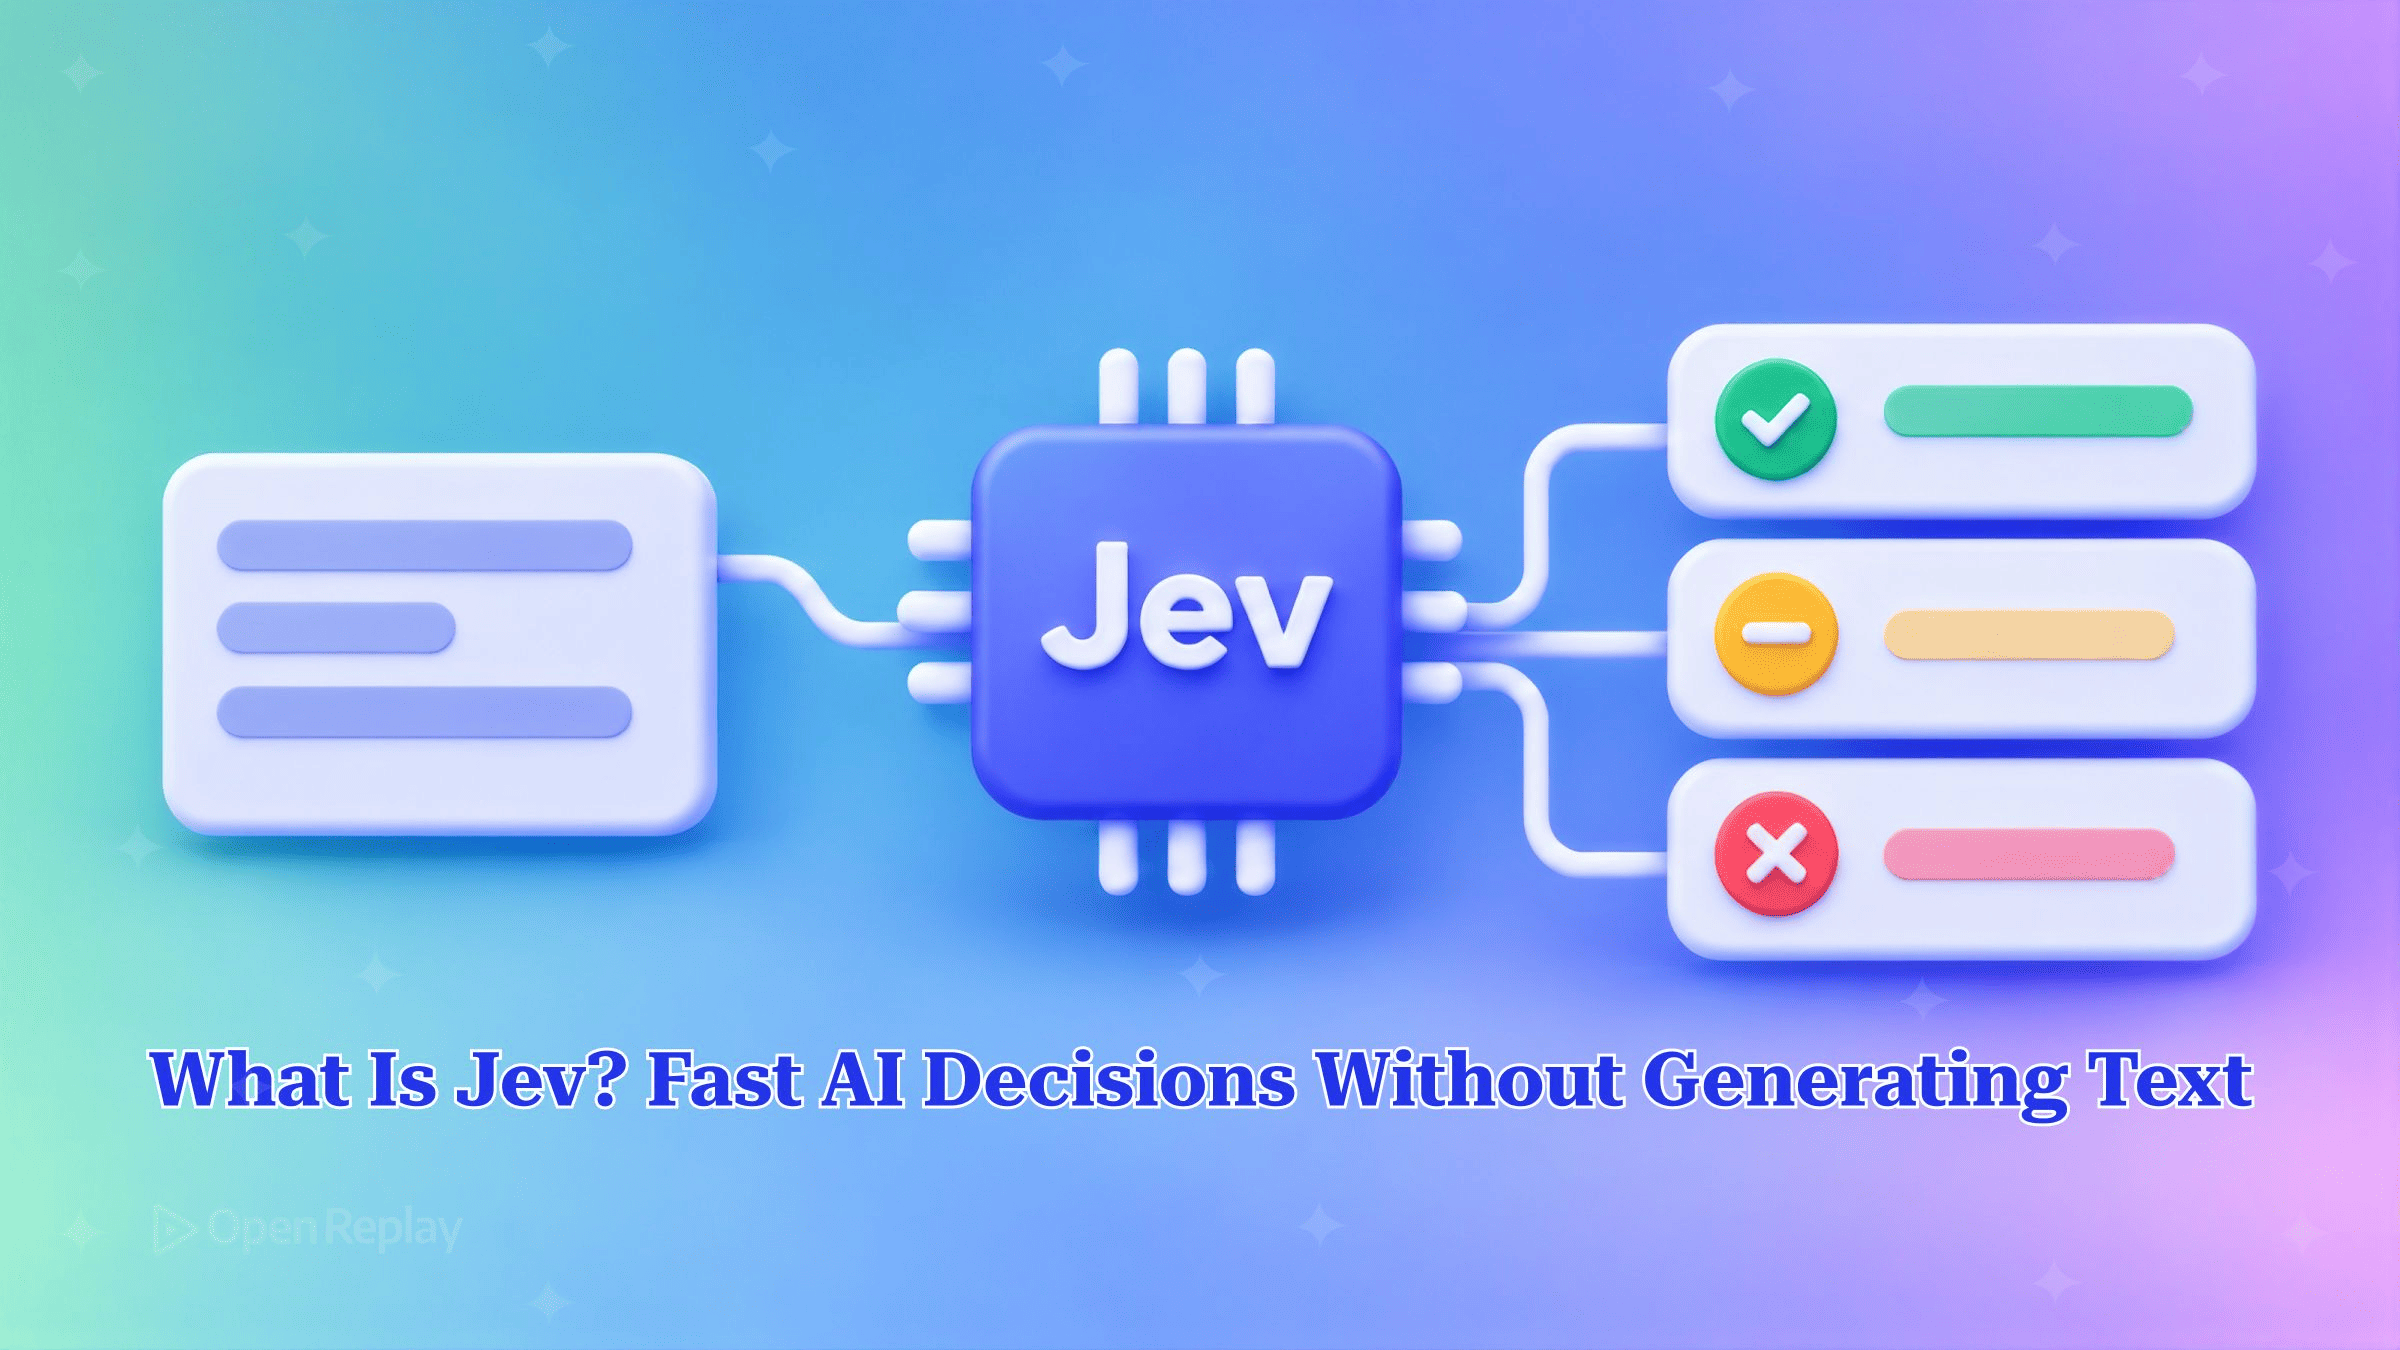
O Jev é um modelo de decisão da TypeSafe AI. Você envia a ele um estado e um conjunto de perguntas tipadas, e ele devolve uma resposta estruturada com probabilidades para cada pergunta. Ele não gera texto.
Se a sua etapa de roteamento é um chat completion que pede JSON e depois executa json.loads dentro de um bloco try, você já conhece os custos: você espera pelos tokens gerados, paga por eles e, de vez em quando, a saída não passa na validação do seu schema. Este artigo explica o que o Jev retorna, como é uma requisição ao endpoint da própria TypeSafe e quais das suas etapas de decisão baseadas em LLM ele pode, de forma realista, assumir.
Principais conclusões
- O Jev é o primeiro dos modelos System One da TypeSafe AI. Foi lançado em 15 de setembro de 2026 e responde a perguntas tipadas com valores estruturados, não com prosa.
- Uma requisição ao Jev tem três campos obrigatórios de nível superior:
state,modelequestions. A resposta contém um objetoanswersindexado pelos ids das suas perguntas, além dousagede tokens. - O Jev tem três tipos de pergunta para decisões sobre texto. Choice escolhe uma opção entre até 255, Score posiciona a entrada em uma rubrica ordenada de 2 a 10 níveis e Noul retorna a probabilidade de que uma resposta do tipo sim/não seja sim.
- A TypeSafe cobra US$ 0,042 por milhão de tokens de entrada no Jev, e os tokens de saída são gratuitos.
- As respostas do Jev sempre vêm do espaço de respostas definido na requisição. Isso elimina erros de parsing e de schema, mas não torna as respostas corretas.
O que é o Jev AI?
O Jev é um modelo da TypeSafe AI que toma decisões onde um LLM comum escreveria texto, e é o primeiro modelo de uma classe que a TypeSafe chama de modelos System One. No anúncio de lançamento, a TypeSafe o descreveu como uma nova classe de modelos de fronteira criada para tomar decisões rápidas e estruturadas que o software pode usar diretamente. O nome vem do modo de pensamento rápido e intuitivo do “Sistema 1” de Kahneman. O acesso é feito por meio de early access.
Como o Jev transforma estado em respostas tipadas?
O Jev recebe um state (texto ou JSON), um identificador model e um mapa de questions, e retorna uma resposta tipada por pergunta, cada uma com probabilidades. Ele avalia todas as perguntas em paralelo. A documentação do Noul observa que adicionar perguntas a uma requisição quase não altera o tempo de resposta. Você mesmo escolhe os ids das perguntas, e eles não são enviados ao modelo.
A referência da API define três tipos de pergunta para decisões sobre texto. Um quarto tipo, box, localiza uma região em uma imagem e só está disponível por meio de um header experimental opcional.
| Tipo | Quando usar | Entradas | Campos retornados |
|---|---|---|---|
| Choice | A resposta é uma entre várias opções | instructions, mais criteria mapeando cada opção (até 255) para uma descrição ou null | choice, probabilities, confidence |
| Score | A resposta é um grau em uma escala ordenada | instructions, mais criteria como um array ordenado de 2 a 10 níveis | score, legend (índice do nível para o rótulo), probabilities, confidence |
| Noul | A resposta é sim ou não | instructions, criteria opcional com descrições de true/false | noul (probabilidade de 0 a 1) |
Uma resposta Noul é um único número entre 0 e 1 e não tem um valor de confiança separado. Com apenas dois resultados possíveis, uma única probabilidade descreve completamente ambos.
Uma requisição e uma resposta Noul
A requisição abaixo faz duas perguntas de sim/não sobre uma única mensagem de suporte. Ela é enviada para POST https://api.typesafe.ai/v1/systemone com um bearer token. As requisições usam o alias jev-latest, e a resposta informa qual versão concreta atendeu a chamada. A página de modelos lista a versão para a qual o alias aponta atualmente.
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My order arrived damaged and I want my money back.",
    "questions": {
      "wants_refund": {
        "type": "noul",
        "instructions": "Is the customer asking for a refund?"
      },
      "mentions_damage": {
        "type": "noul",
        "instructions": "Does the customer report a damaged item?",
        "criteria": {
          "true": "Describes the product as broken, damaged, or defective",
          "false": "No mention of physical damage"
        }
      }
    }
  }'
A resposta segue o formato abaixo. As probabilidades e contagens de tokens são ilustrativas, não uma saída registrada. Os exemplos registrados na documentação do Noul da TypeSafe são saídas do jev-1.13.0.
{
  "model": "jev-1.14.0",
  "answers": {
    "wants_refund": { "type": "noul", "noul": 0.97 },
    "mentions_damage": { "type": "noul", "noul": 0.95 }
  },
  "usage": { "input_tokens": 120, "output_tokens": 2 }
}
O campo output_tokens continua aparecendo em usage, mesmo que a saída não seja cobrada. Qualquer cliente HTTP pode enviar esse body. Segundo o quickstart, a TypeSafe também disponibiliza um SDK para Python (pip install typesafe-sdk, importado como typesafe_sdk e chamado por meio de client.system_one), além de um SDK para JavaScript/TypeScript publicado como @typesafe-ai/sdk.
Quando usar o Jev para roteamento, classificação e seleção de ferramentas?
O Jev se encaixa em etapas de decisão que têm um espaço de respostas finito: rotear uma requisição, classificar um ticket, pontuar conteúdo segundo uma rubrica ou escolher uma ferramenta para um agente. Se o seu código já extrai um rótulo ou um número de um chat completion, essa etapa é uma candidata.
Encaminhar uma mensagem de suporte para uma equipe é uma pergunta Choice, porque a resposta é exatamente uma entre várias opções:
from typesafe_sdk import Choice, TypeSafeClient

TEAMS = {
    "billing": "Charges, invoices, refunds, payment methods",
    "technical": "Bugs, errors, outages, integration problems",
    "account": "Login, password resets, access, account settings",
}

def route_ticket(message: str) -> str:
    # TypeSafeClient reads TYPESAFE_API_KEY from the environment.
    with TypeSafeClient(model="jev-latest") as client:
        response = client.system_one(
            state=message,
            questions={
                "team": Choice(
                    instructions="Which team should handle this support message?",
                    criteria=TEAMS,
                ),
            },
        )
    answer = response.answers["team"]
    if answer.confidence < 0.8:
        return "triage"
    return answer.choice
A função retorna uma das três chaves do dicionário ou recorre a "triage", então não há nenhuma string para validar. O limite de 0,8 é um valor provisório para você ajustar com base no seu próprio tráfego, e não uma recomendação da TypeSafe. Para perguntas Noul, a documentação da TypeSafe sugere 0,7 e 0,3 como limites iniciais, com a faixa intermediária encaminhada para revisão humana.
O roteamento também é o ponto em que o Jev se combina com um gateway de modelos como o 9router: o gateway envia as requisições aos modelos, enquanto o Jev toma a decisão de roteamento.
O que o Jev não consegue fazer?
O Jev não gera texto livre. Um pipeline que o utiliza para rotear ou classificar uma mensagem ainda precisa de um modelo generativo para escrever a resposta. O post de lançamento apresenta a renúncia à geração de texto como uma troca deliberada em favor de velocidade e custo. Na prática, isso significa que o Jev escolhe a equipe, a ferramenta ou a prioridade, e um LLM continua escrevendo o e-mail, o resumo ou o código.
Quais são os limites e ressalvas do Jev?
O Jev é um modelo proprietário servido pela API hospedada da TypeSafe. A TypeSafe não publicou os pesos. As únicas alavancas que você tem são as instructions e os criteria que você escreve. O serviço está em early access, então espere mudanças na superfície da API, nas versões do modelo e nos preços. O próprio post de lançamento diz que os preços podem mudar.
A TypeSafe cobra US$ 0,042 por milhão de tokens de entrada no Jev, com saída gratuita, e informa de 70 a 500 milissegundos por chamada. Os números de destaque de 193,6x mais rápido e 444,6x mais barato vêm das próprias avaliações de workflow da TypeSafe. Essas avaliações pontuam os modelos em relação à média das respostas de dois grandes LLMs de referência, e a TypeSafe descreve os ganhos como o limite superior do que se pode esperar na prática. No mesmo benchmark, o Jev obtém cerca de 68%, o que o coloca ao lado de LLMs de nível intermediário. Esse número mede a concordância com os modelos de referência, não a acurácia em relação a um ground truth rotulado por humanos. Testes independentes tiveram resultados inferiores em algumas tarefas. Em um benchmark público de phishing com 2.000 e-mails, o Jev obteve 62,6% em uma única pergunta “isto é phishing?”, contra 81,3% do Claude Haiku 4.5. Faça benchmarks da sua própria tarefa antes de substituir qualquer coisa.
Type-safe não significa correto. O espaço de respostas restringe a saída, o que elimina falhas de schema, mas o Jev ainda pode escolher a opção errada com alta confiança. Trate as probabilidades dele como sinais para aplicar limites, registrar em log e revisar.
Conclusão
O Jev transforma uma etapa de decisão em uma chamada de função tipada: estado e perguntas entram, probabilidades saem, e nada precisa de parsing. Ele não substitui o seu modelo generativo. Ele substitui as chamadas de LLM cuja única função é produzir um rótulo. Um bom próximo passo é pegar um prompt de classificação ou roteamento que você já usa, reescrevê-lo como uma pergunta Choice ou Noul e executar as duas versões na mesma amostra de tráfego real antes de confiar em qualquer uma delas.
Perguntas frequentes
Devo usar Noul ou Score para perguntas sobre grau, como nível de habilidade ou urgência?
Use Score. Um Noul retorna apenas a probabilidade de a resposta ser sim, então 0,5 significa que o modelo está dividido, e não que algo está em um nível médio. A documentação da TypeSafe mostra isso com a pergunta 'Is the candidate strong in Python?'. Quatro currículos retornaram valores Noul de 0,03, 0,14, 0,81 e 0,92. Um Score de quatro níveis posicionou os mesmos currículos em 0,0, 1,0, 2,05 e 2,89, cada um sobre ou próximo de um nível definido pelo desenvolvedor.
Como lidar com uma decisão com mais de 255 opções em uma pergunta Choice?
Divida-a em duas etapas. Um único Choice aceita até 255 opções. Para conjuntos maiores, o post de lançamento da TypeSafe descreve pontuar os candidatos de forma independente primeiro e depois executar um Choice explícito sobre os poucos mais bem colocados. A TypeSafe diz que isso é mais lento do que uma única chamada. As descrições das opções fazem parte da requisição, então também contam para o limite de contexto de 64k tokens por requisição.
O Jev funciona com o Vercel AI SDK?
Sim. A Vercel disponibiliza o provider @ai-sdk/typesafe-ai, e o Vercel AI Gateway lista o Jev sob o model id typesafe-ai/jev. As chamadas passam por uma função experimental do AI SDK 7, então o nome e o formato dela ainda podem mudar. O provider renomeia Noul para 'boolean' e retorna a resposta em um campo probability em vez de noul, então uma pergunta copiada da documentação da TypeSafe precisa ter o type alterado de 'noul' para 'boolean'. Choice e Score mantêm seus nomes.
Quanta entrada uma única requisição ao Jev pode conter?
Por padrão, uma requisição ao Jev precisa respeitar dois limites: 64k tokens para o state somado a todas as perguntas e 32k tokens para o state somado a qualquer pergunta individual. Não há um limite separado para a quantidade de perguntas enviadas. Enviar o header TypeSafe-Danger-Zone-Long-Context definido como true eleva ambos os limites para 262k tokens no Jev 1.13 e 1.14. A TypeSafe diz que o contexto longo é mais lento e menos preciso do que os limites padrão, então ative-o apenas nas requisições que realmente precisarem.
Gain Debugging Superpowers
Unleash the power of session replay to reproduce bugs, track slowdowns and uncover frustrations in your app. Get complete visibility into your frontend with OpenReplay — the most advanced open-source session replay tool for developers.
Star on GitHub12k