Что такое Jev? Быстрые решения ИИ без генерации текста
Узнайте, как Jev AI превращает состояние в типизированные решения для маршрутизации и классификации. Примеры API, цены, ограничения и рекомендации.

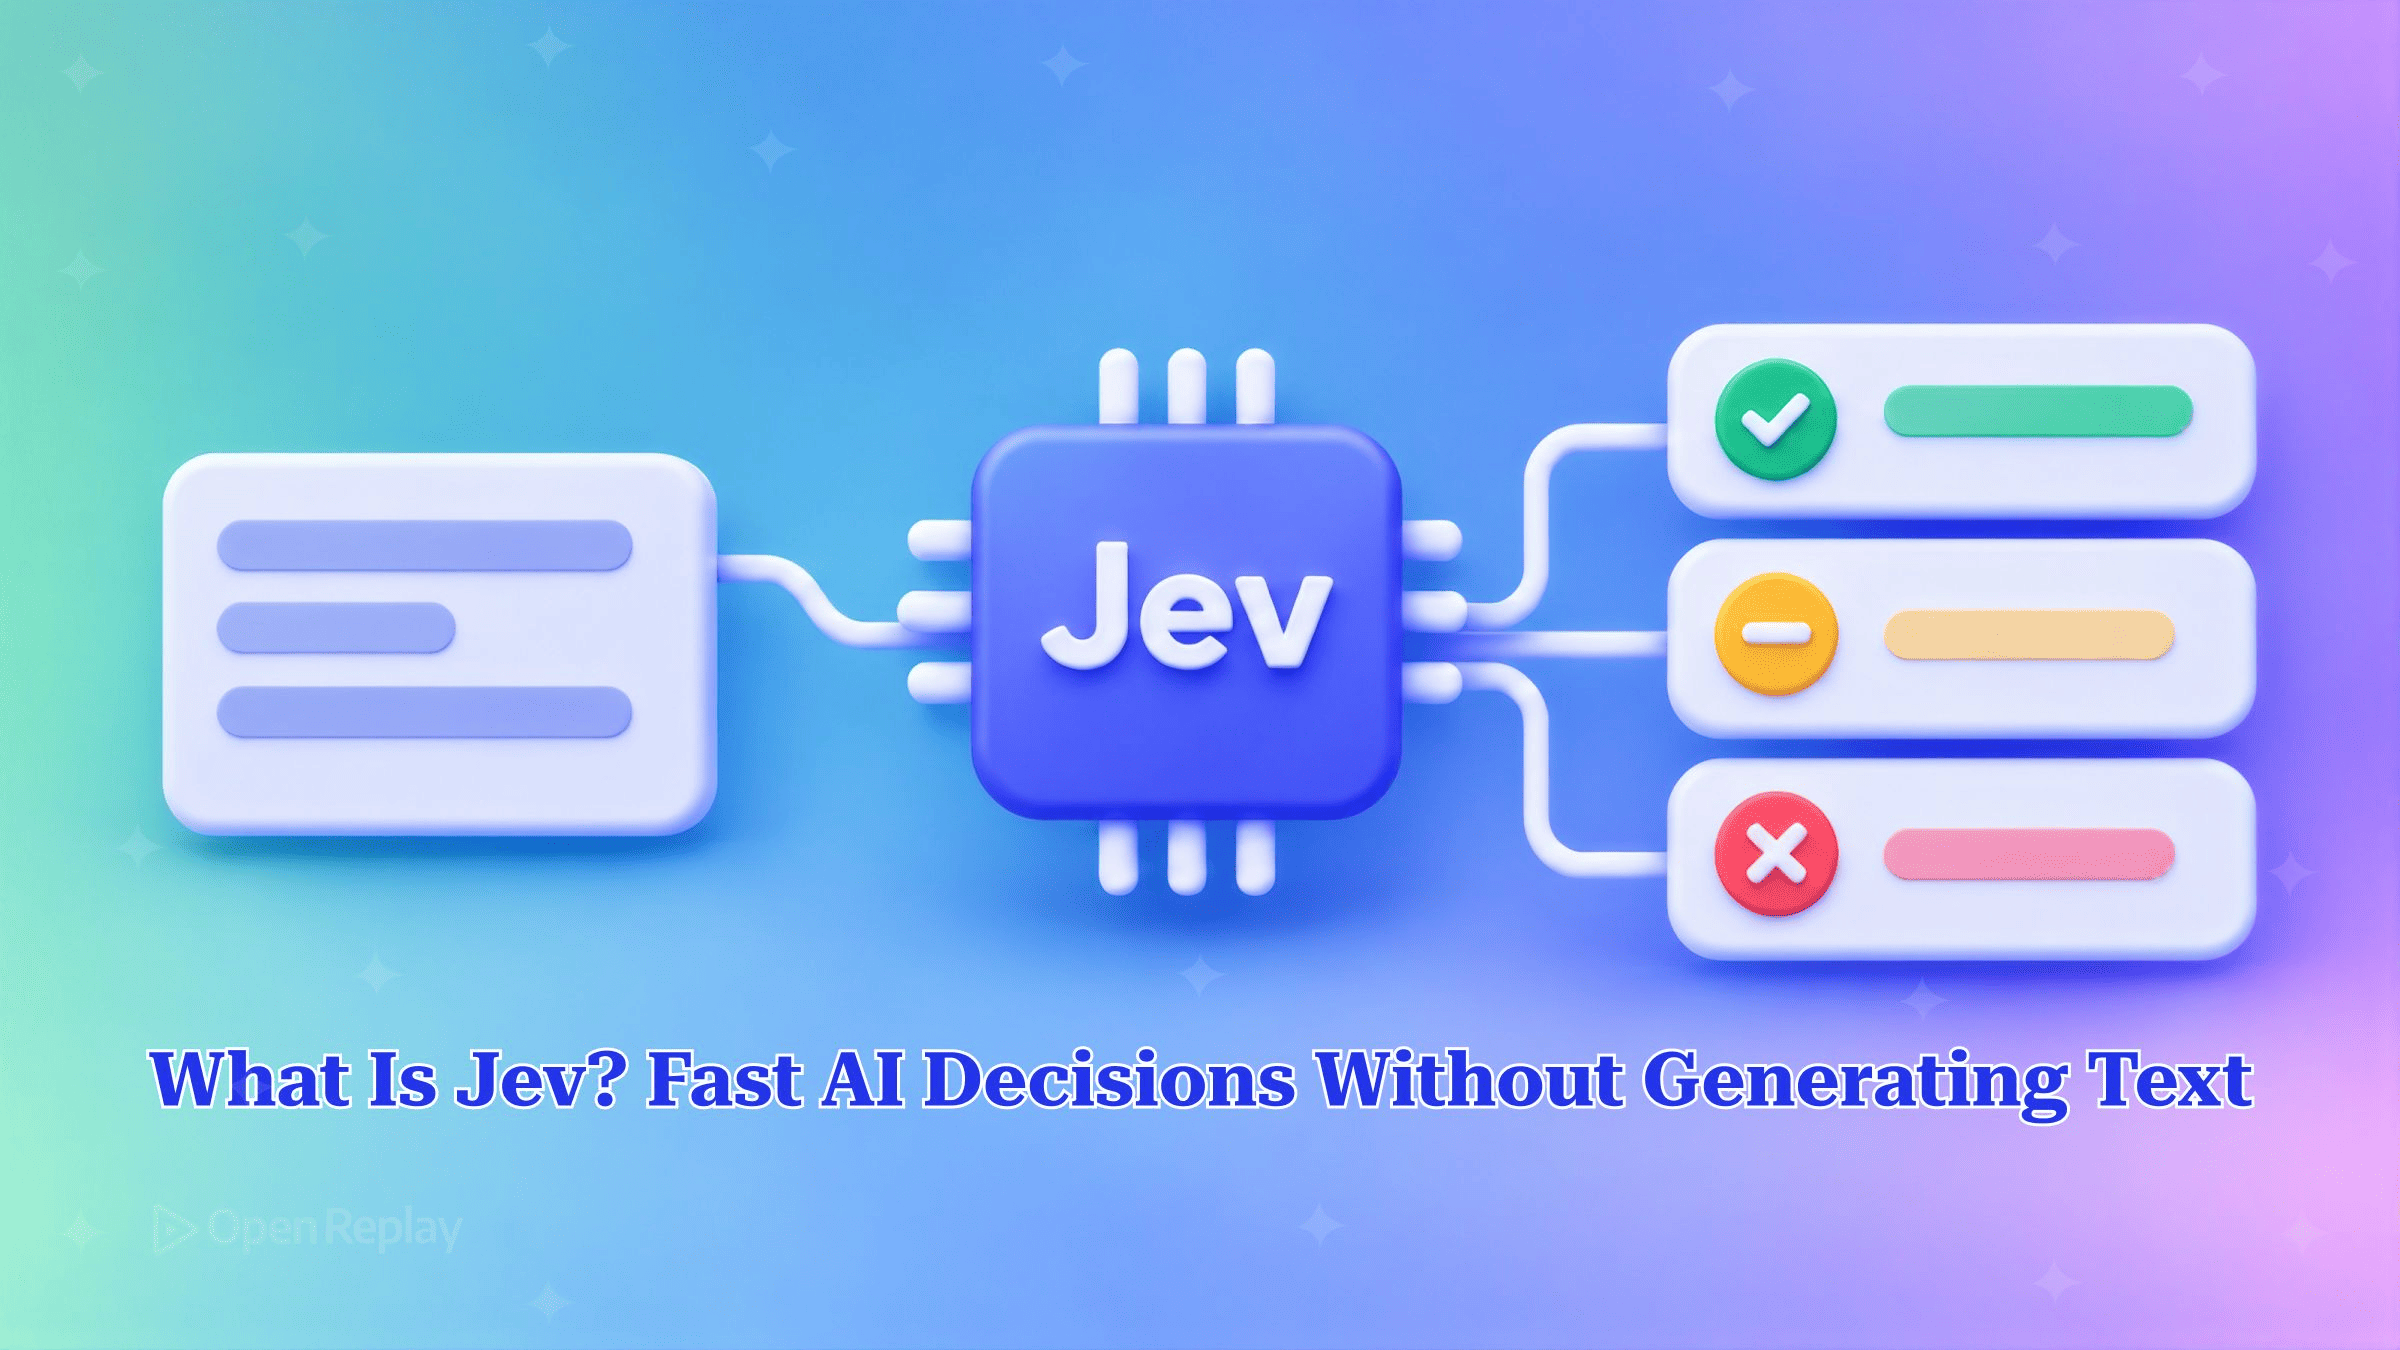
Jev — модель принятия решений от TypeSafe AI. Вы передаёте ей фрагмент состояния и набор типизированных вопросов, а она возвращает структурированный ответ с вероятностями по каждому вопросу. Текст она не генерирует.
Если на этапе маршрутизации у вас стоит chat completion, который просит вернуть JSON, а затем вызывает json.loads внутри блока try, издержки вам уже знакомы. Вы ждёте генерации токенов и платите за них, а время от времени вывод ещё и не проходит проверку по схеме. В этой статье разберём, что возвращает Jev, как выглядит запрос к собственному эндпоинту TypeSafe и какие этапы принятия решений на базе LLM модель реально может взять на себя.
Ключевые выводы
- Jev — первая из моделей System One от TypeSafe AI. Она вышла 15 сентября 2026 года и отвечает на типизированные вопросы структурированными значениями, а не текстом.
- У запроса к Jev три обязательных поля верхнего уровня:
state,modelиquestions. Ответ содержит объектanswersс ключами по идентификаторам ваших вопросов, а также сведения об использовании токенов вusage. - Для решений по тексту в Jev есть три типа вопросов. Choice выбирает один вариант из не более чем 255. Score помещает входные данные на упорядоченную шкалу оценивания (рубрику) из 2–10 уровней. Noul возвращает вероятность того, что ответ на вопрос «да/нет» — «да».
- TypeSafe берёт за Jev $0,042 за миллион входных токенов, выходные токены бесплатны.
- Ответы Jev всегда берутся из пространства ответов, заданного в запросе. Это исключает ошибки парсинга и несоответствия схеме, но не гарантирует, что ответы верны.
Что такое Jev AI?
Jev — модель TypeSafe AI, которая принимает решения там, где обычная LLM писала бы текст. Это первая модель в классе, который TypeSafe называет моделями System One. В анонсе запуска TypeSafe описала её как новый класс передовых (frontier) моделей, созданных для быстрых структурированных решений, которые программы могут использовать напрямую. Название отсылает к быстрому интуитивному режиму мышления «Система 1» по Канеману. Доступ предоставляется в рамках раннего доступа.
Как Jev превращает состояние в типизированные ответы?
Jev принимает state (текст или JSON), идентификатор model и словарь questions. На каждый вопрос модель возвращает один типизированный ответ с вероятностями. Все вопросы обрабатываются параллельно. В документации по Noul отмечается, что добавление вопросов в запрос почти не влияет на время ответа. Идентификаторы вопросов вы задаёте сами, и в модель они не передаются.
В справочнике по API определены три типа вопросов для решений по тексту. Четвёртый тип, box, находит область на изображении. Он доступен только при явном включении через экспериментальный заголовок.
| Тип | Когда использовать | Входные данные | Возвращаемые поля |
|---|---|---|---|
| Choice | Ответ — один из нескольких вариантов | instructions, а также criteria, где каждому варианту (до 255) сопоставлено описание или null | choice, probabilities, confidence |
| Score | Ответ — степень на упорядоченной шкале | instructions, а также criteria в виде упорядоченного массива из 2–10 уровней | score, legend (соответствие индекса уровня и метки), probabilities, confidence |
| Noul | Ответ — «да» или «нет» | instructions, необязательные criteria с описаниями true/false | noul (вероятность от 0 до 1) |
Ответ Noul — одно число от 0 до 1 без отдельного значения уверенности. При двух возможных исходах одна вероятность полностью описывает оба.
Запрос и ответ Noul
Запрос ниже задаёт два вопроса «да/нет» об одном обращении в поддержку. Он отправляется на POST https://api.typesafe.ai/v1/systemone с bearer-токеном. В запросах используется алиас jev-latest, а в ответе указывается, какая конкретная версия обработала вызов. На странице моделей указано, на какую версию алиас ссылается сейчас.
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My order arrived damaged and I want my money back.",
    "questions": {
      "wants_refund": {
        "type": "noul",
        "instructions": "Is the customer asking for a refund?"
      },
      "mentions_damage": {
        "type": "noul",
        "instructions": "Does the customer report a damaged item?",
        "criteria": {
          "true": "Describes the product as broken, damaged, or defective",
          "false": "No mention of physical damage"
        }
      }
    }
  }'
Ответ имеет структуру, показанную ниже. Вероятности и количество токенов приведены для иллюстрации, это не реальный вывод модели. Реальные примеры в документации TypeSafe по Noul получены на jev-1.13.0.
{
  "model": "jev-1.14.0",
  "answers": {
    "wants_refund": { "type": "noul", "noul": 0.97 },
    "mentions_damage": { "type": "noul", "noul": 0.95 }
  },
  "usage": { "input_tokens": 120, "output_tokens": 2 }
}
Поле output_tokens присутствует в usage, хотя выходные токены не тарифицируются. Такое тело запроса можно отправить любым HTTP-клиентом. Согласно руководству по быстрому старту, у TypeSafe также есть Python SDK: устанавливается через pip install typesafe-sdk, импортируется как typesafe_sdk, вызов идёт через client.system_one. Есть и JavaScript/TypeScript SDK, опубликованный как @typesafe-ai/sdk.
Когда использовать Jev для маршрутизации, классификации и выбора инструментов?
Jev подходит для этапов принятия решений с конечным пространством ответов. Это маршрутизация запросов, классификация тикетов, оценка контента по рубрике или выбор инструмента для агента. Если ваш код уже извлекает метку или число из ответа chat completion, этот этап — кандидат на замену.
Направление обращения в поддержку нужной команде — это вопрос типа Choice, поскольку ответ — ровно один из нескольких вариантов:
from typesafe_sdk import Choice, TypeSafeClient

TEAMS = {
    "billing": "Charges, invoices, refunds, payment methods",
    "technical": "Bugs, errors, outages, integration problems",
    "account": "Login, password resets, access, account settings",
}

def route_ticket(message: str) -> str:
    # TypeSafeClient reads TYPESAFE_API_KEY from the environment.
    with TypeSafeClient(model="jev-latest") as client:
        response = client.system_one(
            state=message,
            questions={
                "team": Choice(
                    instructions="Which team should handle this support message?",
                    criteria=TEAMS,
                ),
            },
        )
    answer = response.answers["team"]
    if answer.confidence < 0.8:
        return "triage"
    return answer.choice
Функция возвращает один из трёх ключей словаря или резервное значение "triage", так что валидировать строку не нужно. Порог 0,8 — условное значение, которое нужно подобрать на собственном трафике, а не рекомендация TypeSafe. Для вопросов Noul документация TypeSafe предлагает начальные пороги 0,7 и 0,3, а промежуточный диапазон отправлять на проверку человеку.
В маршрутизации Jev также хорошо сочетается с модельным шлюзом, например 9router. Шлюз направляет запросы к моделям, а Jev принимает решение о маршрутизации.
Чего Jev не умеет?
Jev не генерирует произвольный текст. Если конвейер использует её для маршрутизации или классификации сообщения, для написания ответа ему всё равно нужна генеративная модель. В анонсе отказ от генерации текста подаётся как осознанный компромисс ради скорости и стоимости. На практике это значит, что Jev выбирает команду, инструмент или приоритет, а письмо, сводку или код по-прежнему пишет LLM.
Каковы ограничения и подводные камни Jev?
Jev — проприетарная модель, доступная через хостируемый API TypeSafe. Веса TypeSafe не публиковала. Влиять на модель можно только через instructions и criteria, которые вы пишете. Сервис находится в раннем доступе, поэтому API, версии моделей и цены могут меняться. В самом анонсе сказано, что цены могут измениться.
TypeSafe берёт за Jev $0,042 за миллион входных токенов при бесплатных выходных и заявляет время ответа от 70 до 500 миллисекунд на вызов. Громкие цифры «в 193,6 раза быстрее и в 444,6 раза дешевле» взяты из собственных оценок на рабочих сценариях TypeSafe. В этих оценках модели сравниваются с усреднёнными ответами двух крупных эталонных LLM. Сама TypeSafe называет такой выигрыш верхней границей того, чего стоит ожидать на практике. В том же бенчмарке Jev набирает около 68%, что ставит её в один ряд с LLM среднего уровня. Эта цифра отражает согласие с эталонными моделями, а не точность относительно размеченных людьми эталонных данных. Независимые тесты на некоторых задачах показали более низкие результаты. В открытом бенчмарке по фишингу на 2000 писем Jev набрала 62,6% на единственном вопросе «Это фишинг?» против 81,3% у Claude Haiku 4.5. Прежде чем что-то заменять, протестируйте модель на своей задаче.
Типобезопасность не означает правильность. Пространство ответов ограничивает вывод и тем самым устраняет ошибки несоответствия схеме, но Jev всё равно может с высокой уверенностью выбрать неверный вариант. Относитесь к её вероятностям как к сигналам: применяйте к ним пороги, логируйте и проверяйте.
Заключение
Jev превращает этап принятия решения в типизированный вызов функции: на вход подаются состояние и вопросы, на выходе получаются вероятности, и ничего не нужно парсить. Генеративную модель Jev не заменяет. Она заменяет те вызовы LLM, единственная задача которых — вернуть метку. Хороший следующий шаг — взять один из существующих промптов для классификации или маршрутизации и переписать его как вопрос Choice или Noul. Затем прогоните обе версии на одной и той же выборке реального трафика, прежде чем доверять любой из них.
Часто задаваемые вопросы
Что использовать для вопросов о степени, например об уровне навыков или срочности, — Noul или Score?
Используйте Score. Noul возвращает только вероятность того, что ответ — «да», поэтому 0,5 означает, что модель колеблется, а не что что-то находится на среднем уровне. В документации TypeSafe это показано на вопросе «Is the candidate strong in Python?». Для четырёх резюме Noul вернул значения 0,03, 0,14, 0,81 и 0,92. Score с четырьмя уровнями поместил те же резюме на 0,0, 1,0, 2,05 и 2,89 — каждое на заданном разработчиком уровне или рядом с ним.
Как быть, если в решении для вопроса Choice больше 255 вариантов?
Разбейте его на два этапа. Один вопрос Choice принимает не более 255 вариантов. Для бо́льших наборов в анонсе TypeSafe предлагается сначала оценить кандидатов по отдельности, а затем выполнить явный Choice среди нескольких лучших. По словам TypeSafe, это медленнее, чем один вызов. Описания вариантов входят в запрос, поэтому они также учитываются в лимите контекста в 64 тыс. токенов на запрос.
Работает ли Jev с Vercel AI SDK?
Да. Vercel поставляет провайдер @ai-sdk/typesafe-ai, а в Vercel AI Gateway Jev доступна под идентификатором модели typesafe-ai/jev. Вызовы идут через экспериментальную функцию AI SDK 7, поэтому её название и сигнатура ещё могут измениться. Провайдер переименовывает Noul в «boolean» и возвращает ответ в поле probability вместо noul. Поэтому у вопроса, скопированного из документации TypeSafe, нужно сменить тип с «noul» на «boolean». Choice и Score сохраняют свои названия.
Какой объём входных данных может содержать один запрос к Jev?
По умолчанию запрос к Jev должен укладываться в два лимита: 64 тыс. токенов на состояние вместе со всеми вопросами и 32 тыс. токенов на состояние вместе с любым одним вопросом. Отдельного ограничения на количество вопросов нет. Заголовок TypeSafe-Danger-Zone-Long-Context со значением true повышает оба лимита до 262 тыс. токенов на Jev 1.13 и 1.14. По словам TypeSafe, режим длинного контекста работает медленнее и менее точно, чем стандартные лимиты, поэтому включайте его только для тех запросов, которым он действительно нужен.
Gain Debugging Superpowers
Unleash the power of session replay to reproduce bugs, track slowdowns and uncover frustrations in your app. Get complete visibility into your frontend with OpenReplay — the most advanced open-source session replay tool for developers.
Star on GitHub12k