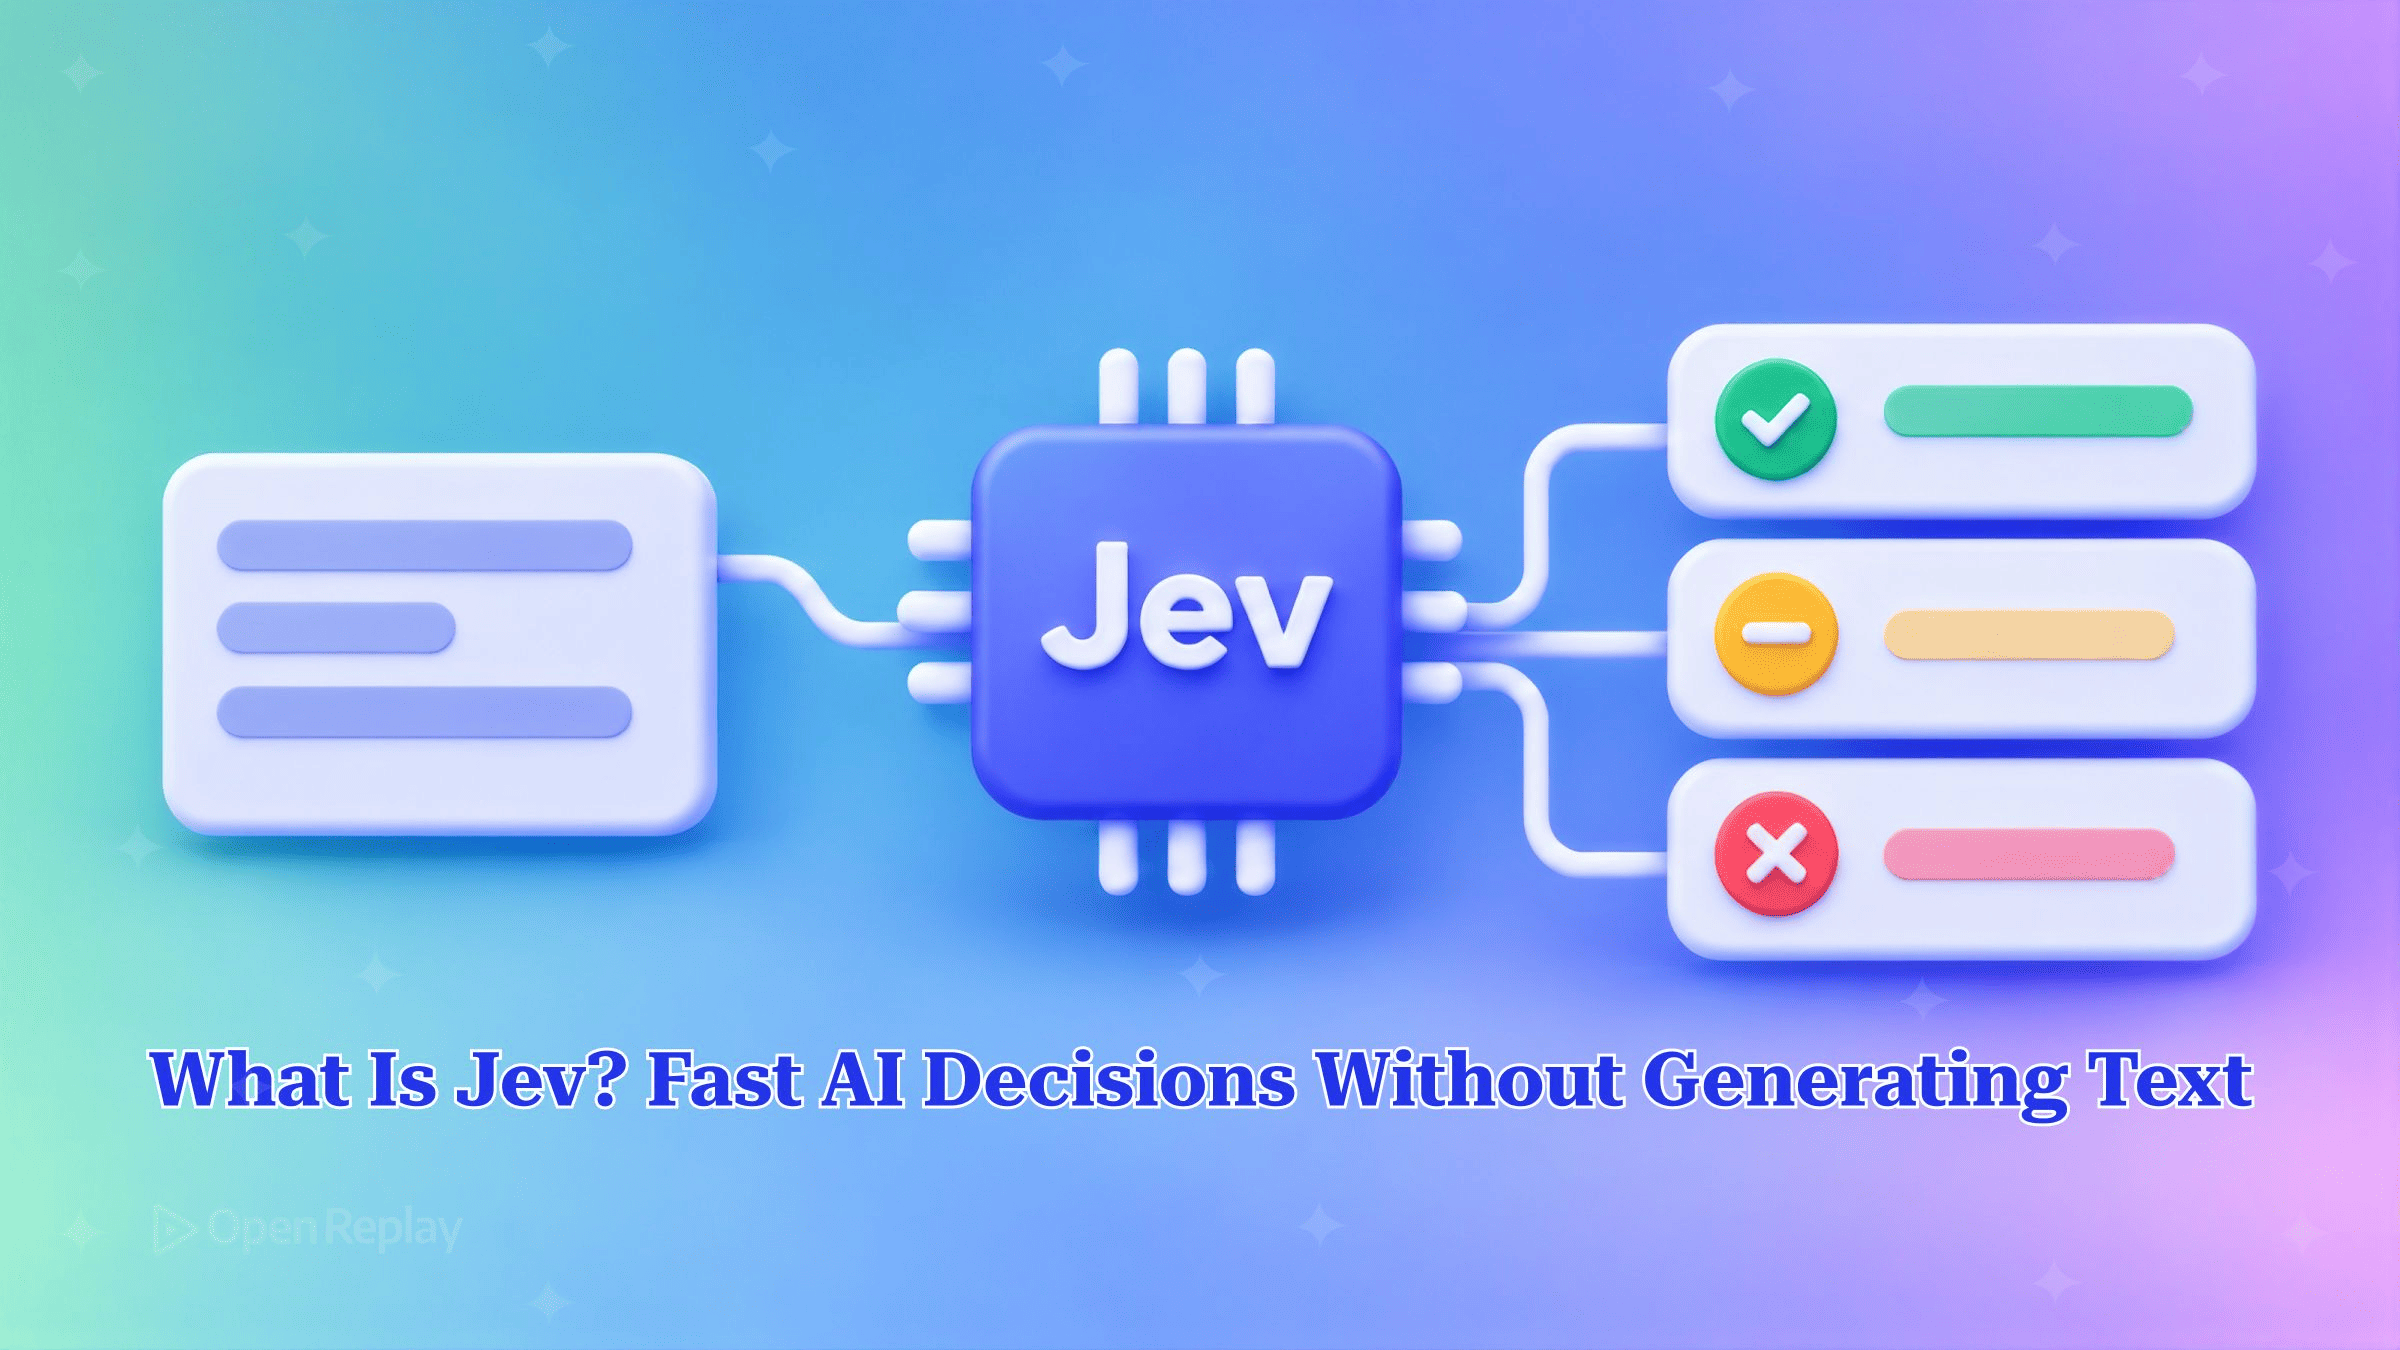
Jev 是 TypeSafe AI 推出的一款决策模型。你向它发送一段状态(state)和一组带类型的问题,它会返回结构化的答案,并为每个问题附上概率。它不生成文本。
如果你的路由步骤是让 chat completion 输出 JSON,再在 try 块里执行 json.loads,那你对其中的代价一定不陌生:要等待 token 逐个生成,要为这些 token 付费,而且输出时不时还会不符合你的 schema。本文将介绍 Jev 返回什么、针对 TypeSafe 官方端点的请求长什么样,以及它在现实中能接管哪些 LLM 决策步骤。
核心要点
- Jev 是 TypeSafe AI 首款 System One 模型,于 2026 年 9 月 15 日发布,它用结构化的值而非文字来回答带类型的问题。
- Jev 请求有三个必填的顶层字段:
state、model和questions。响应中包含一个以你的问题 id 为键的answers对象,以及 token 用量usage。 - Jev 提供三种用于文本决策的问题类型:Choice 从最多 255 个选项中选出一个;Score 将输入映射到一个包含 2 到 10 个等级的有序评分标准上;Noul 返回是非题答案为“是”的概率。
- TypeSafe 对 Jev 的定价为每百万输入 token 0.042 美元,输出 token 免费。
- Jev 的答案始终来自请求中定义的答案空间。这消除了解析错误和 schema 错误,但并不意味着答案一定正确。
Jev AI 是什么?
Jev 是 TypeSafe AI 的一款模型,在普通 LLM 会输出文本的场景中,它直接做出决策。它也是 TypeSafe 所称的 System One 模型这一类别中的首款模型。TypeSafe 在其发布公告中将其描述为一类全新的前沿模型,专为做出快速、结构化、可被软件直接使用的决策而构建。这个名称借用了 Kahneman 提出的快速、直觉式的“系统 1”思维模式。目前可通过抢先体验获取访问权限。
Jev 如何将状态转化为带类型的答案?
Jev 接收一个 state(文本或 JSON)、一个 model 标识符和一个 questions 映射,并为每个问题返回一个带类型的答案,每个答案都附带概率。所有问题会被并行评估。Noul 文档指出,在请求中增加问题数量几乎不会影响响应时间。问题 id 由你自行指定,且不会发送给模型。
API 参考文档定义了三种用于文本决策的问题类型。第四种类型 box 用于在图像中定位区域,仅在主动启用实验性请求头后才可使用。
| 类型 | 适用场景 | 输入 | 返回字段 |
|---|---|---|---|
| Choice | 答案是多个选项之一 | instructions,以及将每个选项(最多 255 个)映射到描述或 null 的 criteria | choice、probabilities、confidence |
| Score | 答案是有序量表上的某个程度 | instructions,以及由 2 到 10 个等级组成的有序数组 criteria | score、legend(等级索引到标签的映射)、probabilities、confidence |
| Noul | 答案为是或否 | instructions,可选的包含 true/false 描述的 criteria | noul(0 到 1 之间的概率) |
Noul 答案是一个介于 0 和 1 之间的数值,没有单独的置信度值。由于只有两种结果,单个概率就足以完整描述这两种结果。
Noul 请求与响应示例
下面的请求针对一条客服消息提出了两个是非题。它通过 bearer token 发送到 POST https://api.typesafe.ai/v1/systemone。请求使用 jev-latest 别名,响应中会注明实际处理该调用的具体版本。模型页面列出了该别名当前指向的版本。
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My order arrived damaged and I want my money back.",
    "questions": {
      "wants_refund": {
        "type": "noul",
        "instructions": "Is the customer asking for a refund?"
      },
      "mentions_damage": {
        "type": "noul",
        "instructions": "Does the customer report a damaged item?",
        "criteria": {
          "true": "Describes the product as broken, damaged, or defective",
          "false": "No mention of physical damage"
        }
      }
    }
  }'
响应结构如下所示。其中的概率和 token 数仅为示意,并非实际记录的输出。TypeSafe 的 Noul 文档中记录的示例为 jev-1.13.0 的输出。
{
  "model": "jev-1.14.0",
  "answers": {
    "wants_refund": { "type": "noul", "noul": 0.97 },
    "mentions_damage": { "type": "noul", "noul": 0.95 }
  },
  "usage": { "input_tokens": 120, "output_tokens": 2 }
}尽管输出不计费,usage 中仍会显示 output_tokens。任何 HTTP 客户端都可以发送此请求体。根据快速入门,TypeSafe 还提供了 Python SDK(通过 pip install typesafe-sdk 安装,以 typesafe_sdk 导入,通过 client.system_one 调用),以及以 @typesafe-ai/sdk 发布的 JavaScript/TypeScript SDK。
何时应使用 Jev 进行路由、分类和工具选择?
Jev 适用于答案空间有限的决策步骤:请求路由、工单分类、按评分标准为内容打分,或为 Agent 选择工具。如果你的代码已经在从 chat completion 的输出中解析标签或数字,那么这个步骤就是可以考虑替换的对象。
将客服消息分派给某个团队属于 Choice 问题,因为答案恰好是若干选项之一:
from typesafe_sdk import Choice, TypeSafeClient

TEAMS = {
    "billing": "Charges, invoices, refunds, payment methods",
    "technical": "Bugs, errors, outages, integration problems",
    "account": "Login, password resets, access, account settings",
}

def route_ticket(message: str) -> str:
    # TypeSafeClient reads TYPESAFE_API_KEY from the environment.
    with TypeSafeClient(model="jev-latest") as client:
        response = client.system_one(
            state=message,
            questions={
                "team": Choice(
                    instructions="Which team should handle this support message?",
                    criteria=TEAMS,
                ),
            },
        )
    answer = response.answers["team"]
    if answer.confidence < 0.8:
        return "triage"
    return answer.choice
该函数要么返回字典中的三个键之一,要么回退到 "triage",因此无需对字符串做任何校验。0.8 这个阈值只是一个占位值,需要你根据自己的实际流量进行调整,并非 TypeSafe 的推荐值。对于 Noul 问题,TypeSafe 文档建议以 0.7 和 0.3 作为初始阈值,介于两者之间的结果则转交人工审核。
路由也是 Jev 与 9router 等模型网关搭配使用的场景:网关负责将请求发送给模型,而 Jev 负责做出路由决策。
Jev 不能做什么?
Jev 不生成自由格式的文本。即使流水线用它来路由或分类消息,仍然需要一个生成式模型来撰写回复。发布文章将放弃文本生成定位为一种为换取速度和成本优势而做出的有意取舍。实际上,这意味着由 Jev 选择团队、工具或优先级,而邮件、摘要或代码仍由 LLM 来撰写。
Jev 有哪些局限和注意事项?
Jev 是一款通过 TypeSafe 托管 API 提供服务的专有模型,TypeSafe 尚未公开模型权重。你唯一能调整的就是自己编写的 instructions 和 criteria。该服务目前处于抢先体验阶段,因此 API 接口、模型版本和定价都可能发生变化。发布文章本身也表示定价可能会调整。
TypeSafe 对 Jev 的定价为每百万输入 token 0.042 美元,输出免费,并宣称每次调用耗时 70 到 500 毫秒。“快 193.6 倍、便宜 444.6 倍”这些醒目数字来自 TypeSafe 自己的工作流评测。这些评测以两个大型参考 LLM 的平均答案为基准来为模型打分,TypeSafe 也表示这些提升代表了实际使用中可预期效果的上限。在同一基准上,Jev 的得分约为 68%,与中端 LLM 处于同一水平。该数字衡量的是与参考模型的一致性,而非相对于人工标注真实标签的准确率。在某些任务上,独立测试的结果更低。在一项公开的包含 2,000 封邮件的钓鱼邮件基准测试中,Jev 在单个“这是钓鱼邮件吗?”问题上的得分为 62.6%,而 Claude Haiku 4.5 为 81.3%。在替换任何组件之前,请先针对你自己的任务做基准测试。
类型安全并不等于正确。答案空间约束了输出,消除了 schema 失败,但 Jev 仍可能以高置信度选出错误的选项。应将其概率视为信号,用于设定阈值、记录日志和人工审核。
结论
Jev 将决策步骤变成了一次带类型的函数调用:输入状态和问题,输出概率,无需任何解析。它不会取代你的生成式模型,它取代的是那些唯一任务就是输出一个标签的 LLM 调用。一个不错的下一步是:挑选一个现有的分类或路由 prompt,将其改写为 Choice 或 Noul 问题,然后在同一批真实流量样本上运行两个版本,在此之前不要轻易信任其中任何一个。
常见问题
对于技能水平或紧急程度这类关于程度的问题,应该使用 Noul 还是 Score?
使用 Score。Noul 只返回答案为“是”的概率,因此 0.5 表示模型拿不准,而不是表示某事物处于中等水平。TypeSafe 文档用“候选人的 Python 能力强吗?”这个问题演示了这一点:四份简历返回的 Noul 值分别为 0.03、0.14、0.81 和 0.92;而使用四级 Score 时,同样的简历分别落在 0.0、1.0、2.05 和 2.89,每个值都位于开发者定义的某个等级上或其附近。
Choice 问题中的选项超过 255 个时该如何处理?
将其拆分为两个阶段。单个 Choice 最多接受 255 个选项。对于更大的集合,TypeSafe 的发布文章介绍的方法是:先对各候选项分别打分,再对排名靠前的几个选项运行一次显式的 Choice。TypeSafe 表示这比单次调用更慢。选项描述属于请求的一部分,因此也会计入每个请求 64k token 的上下文限制。
Jev 能与 Vercel AI SDK 配合使用吗?
可以。Vercel 提供了 @ai-sdk/typesafe-ai provider,Vercel AI Gateway 也以模型 id typesafe-ai/jev 列出了 Jev。调用需通过 AI SDK 7 中的一个实验性函数进行,因此其名称和形式仍可能变化。该 provider 将 Noul 重命名为 'boolean',并在 probability 字段而非 noul 字段中返回答案,因此从 TypeSafe 文档中复制的问题需要将 type 从 'noul' 改为 'boolean'。Choice 和 Score 保持原名不变。
单个 Jev 请求最多可以包含多少输入?
默认情况下,Jev 请求必须同时满足两个限制:state 加上所有问题不超过 64k token,state 加上任意单个问题不超过 32k token。发送的问题数量没有单独上限。在 Jev 1.13 和 1.14 上,发送值为 true 的 TypeSafe-Danger-Zone-Long-Context 请求头可将这两个限制都提升到 262k token。TypeSafe 表示,长上下文模式比默认限制下更慢、准确率更低,因此仅应在确有需要的请求中启用。
Gain Debugging Superpowers
Unleash the power of session replay to reproduce bugs, track slowdowns and uncover frustrations in your app. Get complete visibility into your frontend with OpenReplay — the most advanced open-source session replay tool for developers.
Star on GitHub12k