Jevとは?テキストを生成せずに高速なAI判断を実現する
Jev AIが状態をルーティングや分類向けの型付き判断に変える仕組みを解説。API例、料金、制限、活用すべき場面も紹介します。

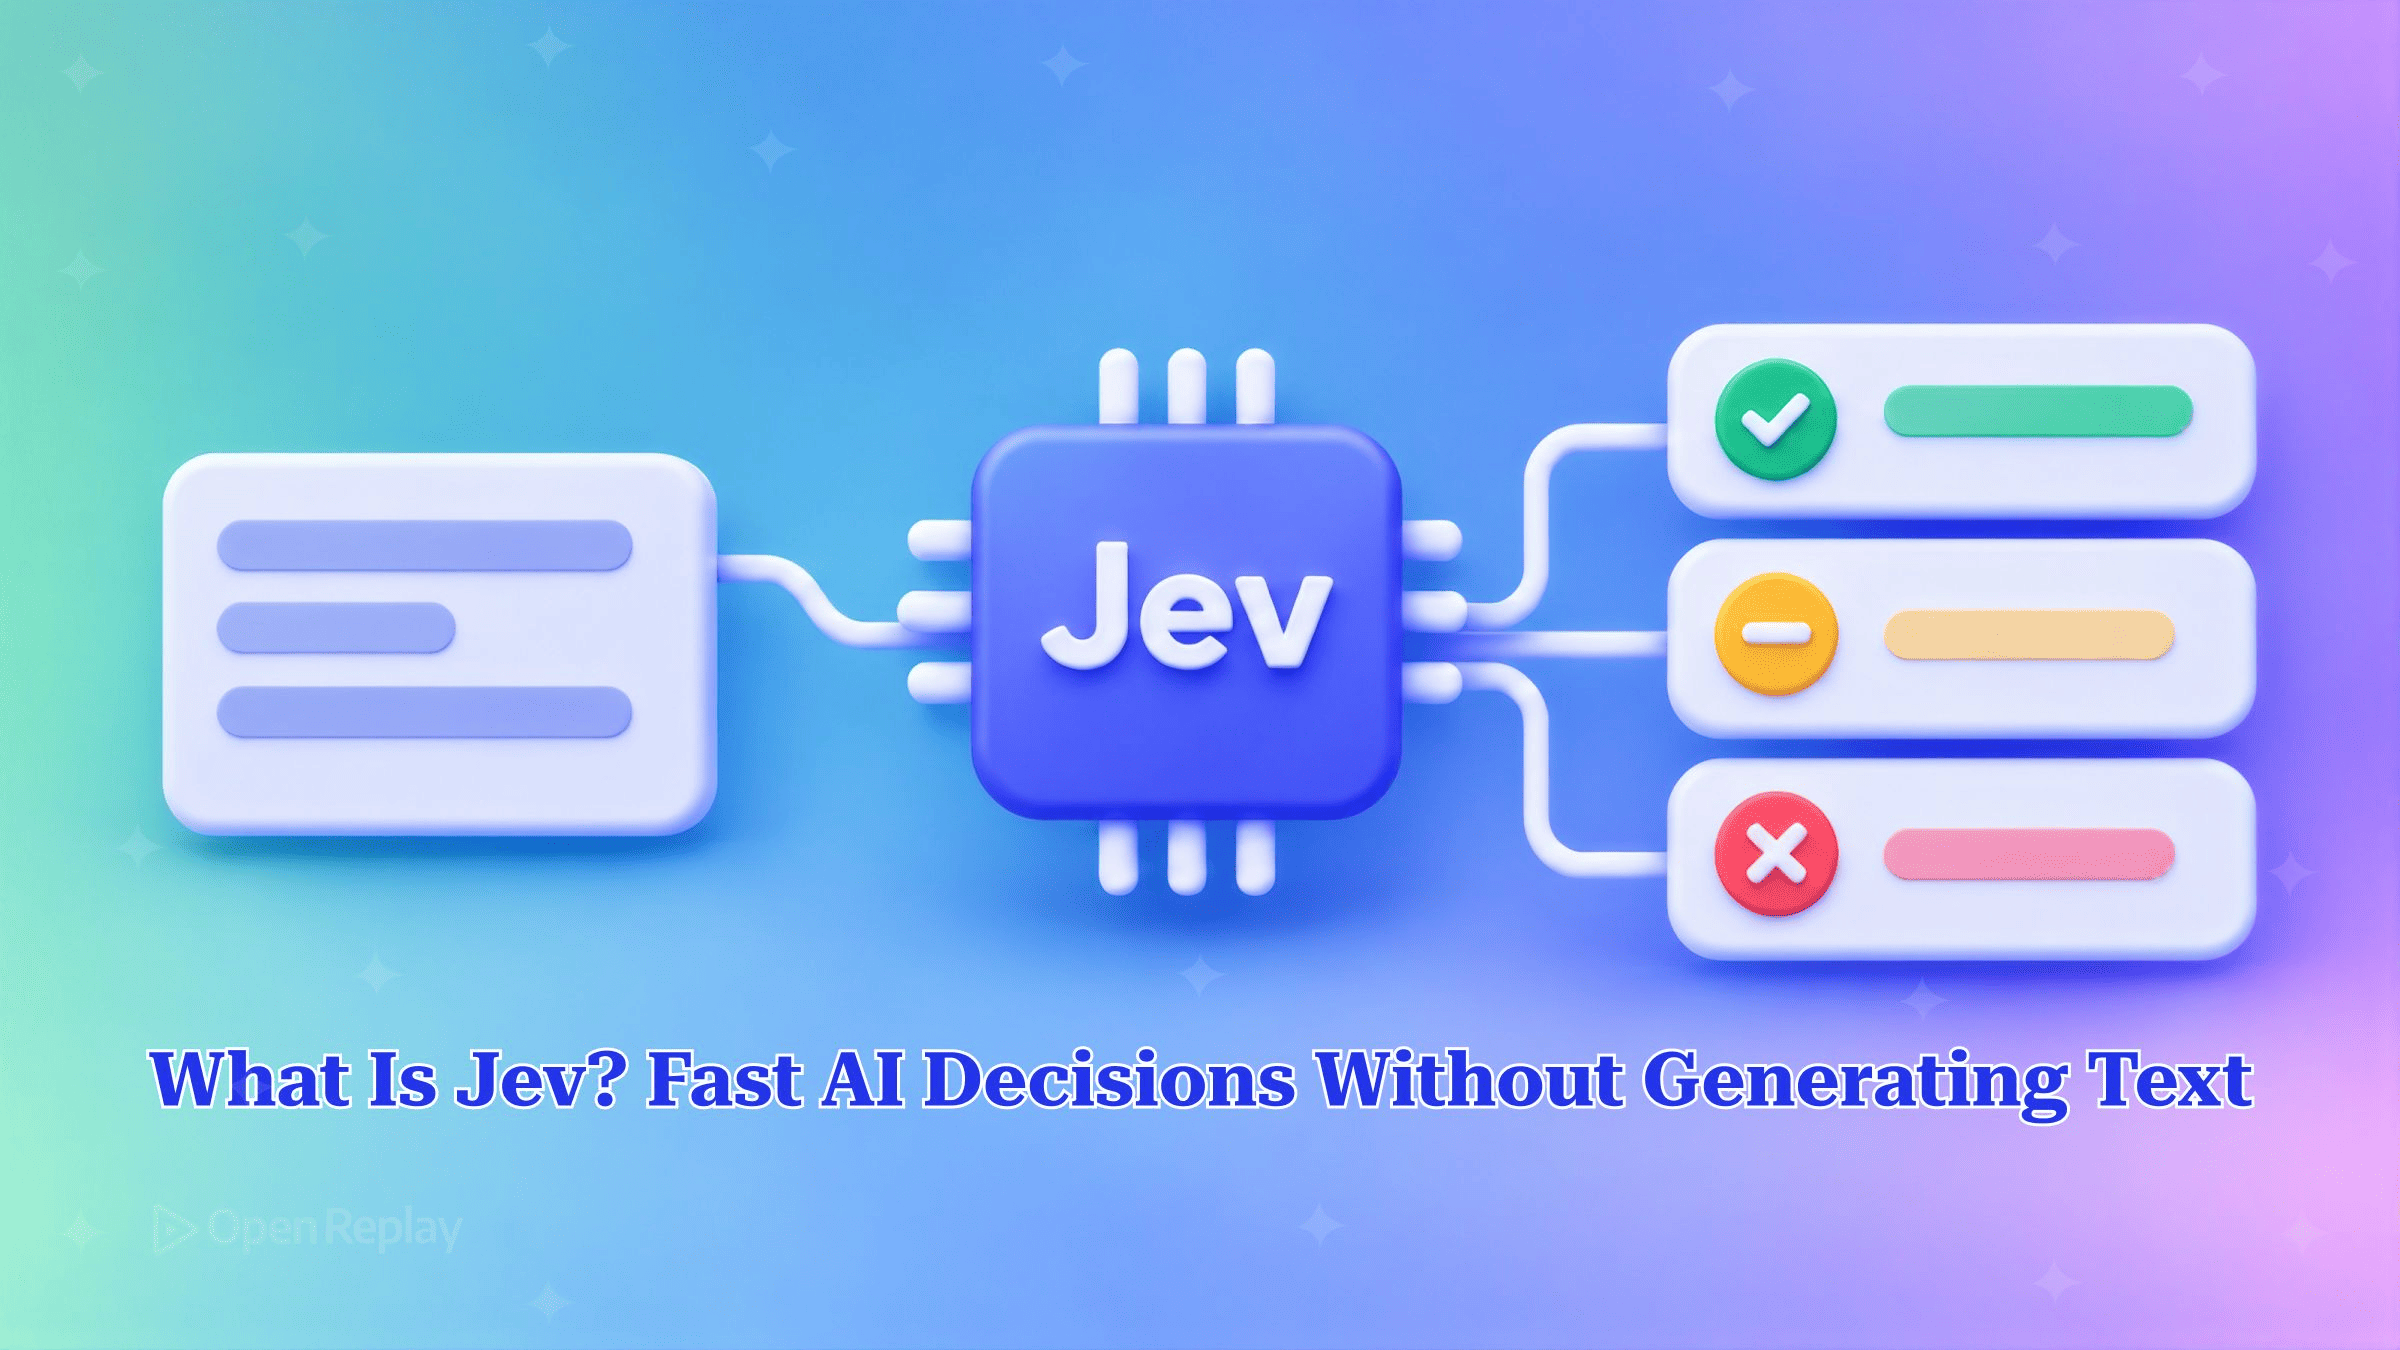
Jevは、TypeSafe AIが提供する意思決定モデルです。状態(state)と型付きの質問のセットを送ると、各質問に対する確率付きの構造化された回答が返ってきます。テキストは生成しません。
ルーティング処理をチャット補完で実装し、JSONを出力させてtryブロック内でjson.loadsを実行しているなら、そのコストはすでにご存じでしょう。生成されるトークンを待つ時間がかかり、その分の料金も発生し、ときには出力がスキーマに合致しないこともあります。本記事では、Jevが何を返すのか、TypeSafe自身のエンドポイントに対するリクエストがどのようなものか、そしてLLMによる判断処理のうちどれを現実的にJevへ置き換えられるのかを解説します。
重要なポイント
- JevはTypeSafe AIのSystem Oneモデルの第一弾です。2026年9月15日にリリースされ、型付きの質問に対して文章ではなく構造化された値で回答します。
- Jevのリクエストには、
state、model、questionsの3つの必須トップレベルフィールドがあります。レスポンスには、質問IDをキーとするanswersオブジェクトと、トークンのusageが含まれます。 - Jevにはテキスト判断用の3つの質問タイプがあります。Choiceは最大255個の選択肢から1つを選び、Scoreは入力を2〜10段階の順序付きルーブリック上に位置付け、Noulはyes/noの答えがyesである確率を返します。
- TypeSafeはJevの料金を入力トークン100万あたり0.042ドルに設定しており、出力トークンは無料です。
- Jevの回答は常にリクエストで定義された回答空間の中から返されます。これによりパースエラーやスキーマエラーは起こりませんが、回答が正しいことを保証するものではありません。
Jev AIとは?
Jevは、通常のLLMがテキストを書く場面で「判断」を行うTypeSafe AIのモデルであり、TypeSafeが「System Oneモデル」と呼ぶクラスの最初のモデルです。TypeSafeはローンチ発表の中で、Jevを「ソフトウェアが直接利用できる、高速かつ構造化された判断を行うために構築された、新しいクラスのフロンティアモデル」と説明しています。名称は、カーネマンが提唱した高速で直感的な思考モード「システム1」に由来しています。利用はアーリーアクセスを通じて可能です。
Jevはどのように状態を型付きの回答に変換するのか?
Jevはstate(テキストまたはJSON)、model識別子、questionsのマップを受け取り、質問ごとに確率付きの型付き回答を1つずつ返します。すべての質問は並列に評価されます。Noulのドキュメントによると、リクエストに質問を追加してもレスポンス時間はほとんど変わりません。質問IDは自由に設定でき、モデルには送信されません。
APIリファレンスでは、テキスト判断用に3つの質問タイプが定義されています。4つ目のタイプであるboxは画像内の領域を特定するもので、オプトイン方式の実験的ヘッダーを指定した場合にのみ利用できます。
| タイプ | 使用場面 | 入力 | 返されるフィールド |
|---|---|---|---|
| Choice | 答えが複数の選択肢のいずれかである場合 | instructions、および各選択肢(最大255個)を説明文またはnullに対応付けるcriteria | choice、probabilities、confidence |
| Score | 答えが順序付きスケール上の程度である場合 | instructions、および2〜10段階の順序付き配列としてのcriteria | score、legend(レベルのインデックスとラベルの対応)、probabilities、confidence |
| Noul | 答えがyesまたはnoである場合 | instructions、true/falseの説明を含む任意のcriteria | noul(0〜1の確率) |
Noulの回答は0〜1の間の単一の数値であり、個別の信頼度(confidence)の値はありません。結果が2通りしかないため、1つの確率で両方を完全に表現できるからです。
Noulのリクエストとレスポンス
以下のリクエストは、1件のサポートメッセージについて2つのyes/no質問を行うものです。Bearerトークンを付けてPOST https://api.typesafe.ai/v1/systemoneに送信します。リクエストではjev-latestエイリアスを使用し、実際にどの具体的なバージョンが処理したかはレスポンスで報告されます。エイリアスが現在どのバージョンを指しているかは、モデルページに記載されています。
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My order arrived damaged and I want my money back.",
    "questions": {
      "wants_refund": {
        "type": "noul",
        "instructions": "Is the customer asking for a refund?"
      },
      "mentions_damage": {
        "type": "noul",
        "instructions": "Does the customer report a damaged item?",
        "criteria": {
          "true": "Describes the product as broken, damaged, or defective",
          "false": "No mention of physical damage"
        }
      }
    }
  }'
レスポンスは以下の形式になります。確率とトークン数は説明用の値であり、実際に記録された出力ではありません。TypeSafeのNoulドキュメントに掲載されている記録済みの例は、jev-1.13.0の出力です。
{
  "model": "jev-1.14.0",
  "answers": {
    "wants_refund": { "type": "noul", "noul": 0.97 },
    "mentions_damage": { "type": "noul", "noul": 0.95 }
  },
  "usage": { "input_tokens": 120, "output_tokens": 2 }
}出力は課金されませんが、usageにはoutput_tokensも表示されます。このリクエストボディは任意のHTTPクライアントから送信できます。クイックスタートによると、TypeSafeはPython SDK(pip install typesafe-sdkでインストールし、typesafe_sdkとしてインポート、client.system_one経由で呼び出し)も提供しています。また、@typesafe-ai/sdkとして公開されているJavaScript/TypeScript SDKもあります。
ルーティング、分類、ツール選択にJevを使うべきなのはどんなときか?
Jevは、回答空間が有限な判断処理に適しています。たとえば、リクエストのルーティング、チケットの分類、ルーブリックに基づくコンテンツの採点、エージェントのツール選択などです。すでにチャット補完の出力からラベルや数値をパースしているコードがあれば、その処理は置き換えの候補になります。
サポートメッセージを担当チームに振り分ける処理は、答えが複数の選択肢のうちちょうど1つになるため、Choice質問として扱えます。
from typesafe_sdk import Choice, TypeSafeClient

TEAMS = {
    "billing": "Charges, invoices, refunds, payment methods",
    "technical": "Bugs, errors, outages, integration problems",
    "account": "Login, password resets, access, account settings",
}

def route_ticket(message: str) -> str:
    # TypeSafeClient reads TYPESAFE_API_KEY from the environment.
    with TypeSafeClient(model="jev-latest") as client:
        response = client.system_one(
            state=message,
            questions={
                "team": Choice(
                    instructions="Which team should handle this support message?",
                    criteria=TEAMS,
                ),
            },
        )
    answer = response.answers["team"]
    if answer.confidence < 0.8:
        return "triage"
return answer.choiceこの関数は3つの辞書キーのいずれかを返すか、"triage"にフォールバックするため、文字列を検証する必要がありません。0.8というしきい値は、自社のトラフィックに合わせて調整するためのプレースホルダーであり、TypeSafeの推奨値ではありません。Noul質問については、TypeSafeのドキュメントで0.7と0.3を初期しきい値とし、その中間の範囲を人間によるレビューに回すことが提案されています。
ルーティングは、Jevが9routerのようなモデルゲートウェイと組み合わせて活用できる領域でもあります。ゲートウェイがリクエストをモデルに送り、Jevがルーティングの判断を行うという役割分担です。
Jevにできないことは?
Jevは自由形式のテキストを生成しません。Jevを使ってメッセージをルーティングまたは分類するパイプラインでも、返信を書くには生成モデルが必要です。ローンチ記事では、テキスト生成を手放すことは速度とコストのための意図的なトレードオフとして位置付けられています。実務的には、Jevがチーム、ツール、優先度を選び、メール、要約、コードは引き続きLLMが書く、という形になります。
Jevの制約と注意点は?
JevはTypeSafeのホスト型APIから提供されるプロプライエタリなモデルです。TypeSafeはモデルの重みを公開していません。ユーザーが調整できるのは、自分で記述するinstructionsとcriteriaだけです。サービスはアーリーアクセス段階にあるため、APIの仕様、モデルのバージョン、料金は変更される可能性があります。ローンチ記事自体にも、料金が変動する可能性があると記載されています。
TypeSafeはJevの料金を入力トークン100万あたり0.042ドル(出力は無料)に設定しており、1回の呼び出しあたり70〜500ミリ秒としています。「193.6倍高速、444.6倍低コスト」という見出しの数値は、TypeSafe独自のワークフロー評価に基づくものです。この評価では、2つの大規模な参照LLMの回答を平均したものに対してモデルを採点しており、TypeSafeはこれらの改善幅を実際に期待できる範囲の上限と説明しています。同じベンチマークでのJevのスコアは約68%で、中位クラスのLLMと同水準です。この数値は参照モデルとの一致度を測るものであり、人間がラベル付けした正解データに対する精度ではありません。独立したテストでは、一部のタスクでより低い結果も出ています。公開されている2,000件のメールを用いたフィッシング判定ベンチマークでは、「これはフィッシングか?」という単一の質問に対し、Claude Haiku 4.5が81.3%だったのに対してJevは62.6%でした。何かを置き換える前に、必ず自分のタスクでベンチマークを実施してください。
型安全であることは、正しいことを意味しません。回答空間によって出力が制約されるためスキーマエラーはなくなりますが、Jevが高い信頼度で誤った選択肢を選ぶ可能性はあります。確率は、しきい値の設定、ログ記録、レビューのためのシグナルとして扱ってください。
まとめ
Jevは、判断処理を型付きの関数呼び出しに変えます。状態と質問を入力すると確率が返され、パースは一切不要です。生成モデルを置き換えるものではなく、ラベルを出力することだけが役割のLLM呼び出しを置き換えるものです。次のステップとしては、既存の分類またはルーティング用プロンプトを1つ選んでChoiceまたはNoul質問として書き直し、どちらかを信頼する前に、実際のトラフィックの同じサンプルで両方のバージョンを実行してみることをおすすめします。
よくある質問
スキルレベルや緊急度のような程度を問う質問には、NoulとScoreのどちらを使うべきですか?
Scoreを使ってください。Noulはyesである確率しか返さないため、0.5はモデルの判断が割れていることを意味し、何かが中程度のレベルにあることを意味するわけではありません。TypeSafeのドキュメントでは、「この候補者はPythonに強いか?」という質問でこれを示しています。4件の履歴書に対して、Noulは0.03、0.14、0.81、0.92という値を返しました。一方、4段階のScoreでは同じ履歴書が0.0、1.0、2.05、2.89に位置付けられ、それぞれ開発者が定義したレベル上、またはその付近に収まりました。
Choice質問で255個を超える選択肢がある判断はどう扱えばよいですか?
2段階に分割してください。1つのChoiceで受け付けられる選択肢は最大255個です。それより大きな集合については、TypeSafeのローンチ記事で、まず候補をそれぞれ独立に採点し、その後上位のいくつかに対して明示的なChoiceを実行する方法が紹介されています。TypeSafeによると、この方法は1回の呼び出しより遅くなります。選択肢の説明文もリクエストの一部であるため、リクエストあたり64kトークンのコンテキスト上限にカウントされます。
JevはVercel AI SDKで使えますか?
はい。Vercelは@ai-sdk/typesafe-aiプロバイダーを提供しており、Vercel AI GatewayではJevがモデルID typesafe-ai/jevとして掲載されています。呼び出しはAI SDK 7の実験的な関数を経由するため、その名前や形式は今後変更される可能性があります。このプロバイダーではNoulが「boolean」に名称変更されており、回答はnoulではなくprobabilityフィールドで返されます。そのため、TypeSafeのドキュメントからコピーした質問は、typeを「noul」から「boolean」に変更する必要があります。ChoiceとScoreは名称が変わりません。
1回のJevリクエストにはどれくらいの入力を含められますか?
デフォルトでは、Jevのリクエストは2つの上限に収まる必要があります。stateとすべての質問の合計で64kトークン、stateと任意の1つの質問の合計で32kトークンです。送信できる質問の数に別途上限はありません。TypeSafe-Danger-Zone-Long-Contextヘッダーをtrueに設定して送信すると、Jev 1.13および1.14では両方の上限が262kトークンに引き上げられます。TypeSafeによると、ロングコンテキストはデフォルトの上限より遅く精度も低くなるため、必要なリクエストに限って有効にしてください。
Gain Debugging Superpowers
Unleash the power of session replay to reproduce bugs, track slowdowns and uncover frustrations in your app. Get complete visibility into your frontend with OpenReplay — the most advanced open-source session replay tool for developers.
Star on GitHub12k