ブラウザ上でAIを使って動画に字幕を付ける
Transformers.jsとWhisperで動画の字幕をブラウザー内で生成。音声を抽出し、WebGPUまたはWASMで処理してWebVTTを作成し、メディアを端末内に保持します。

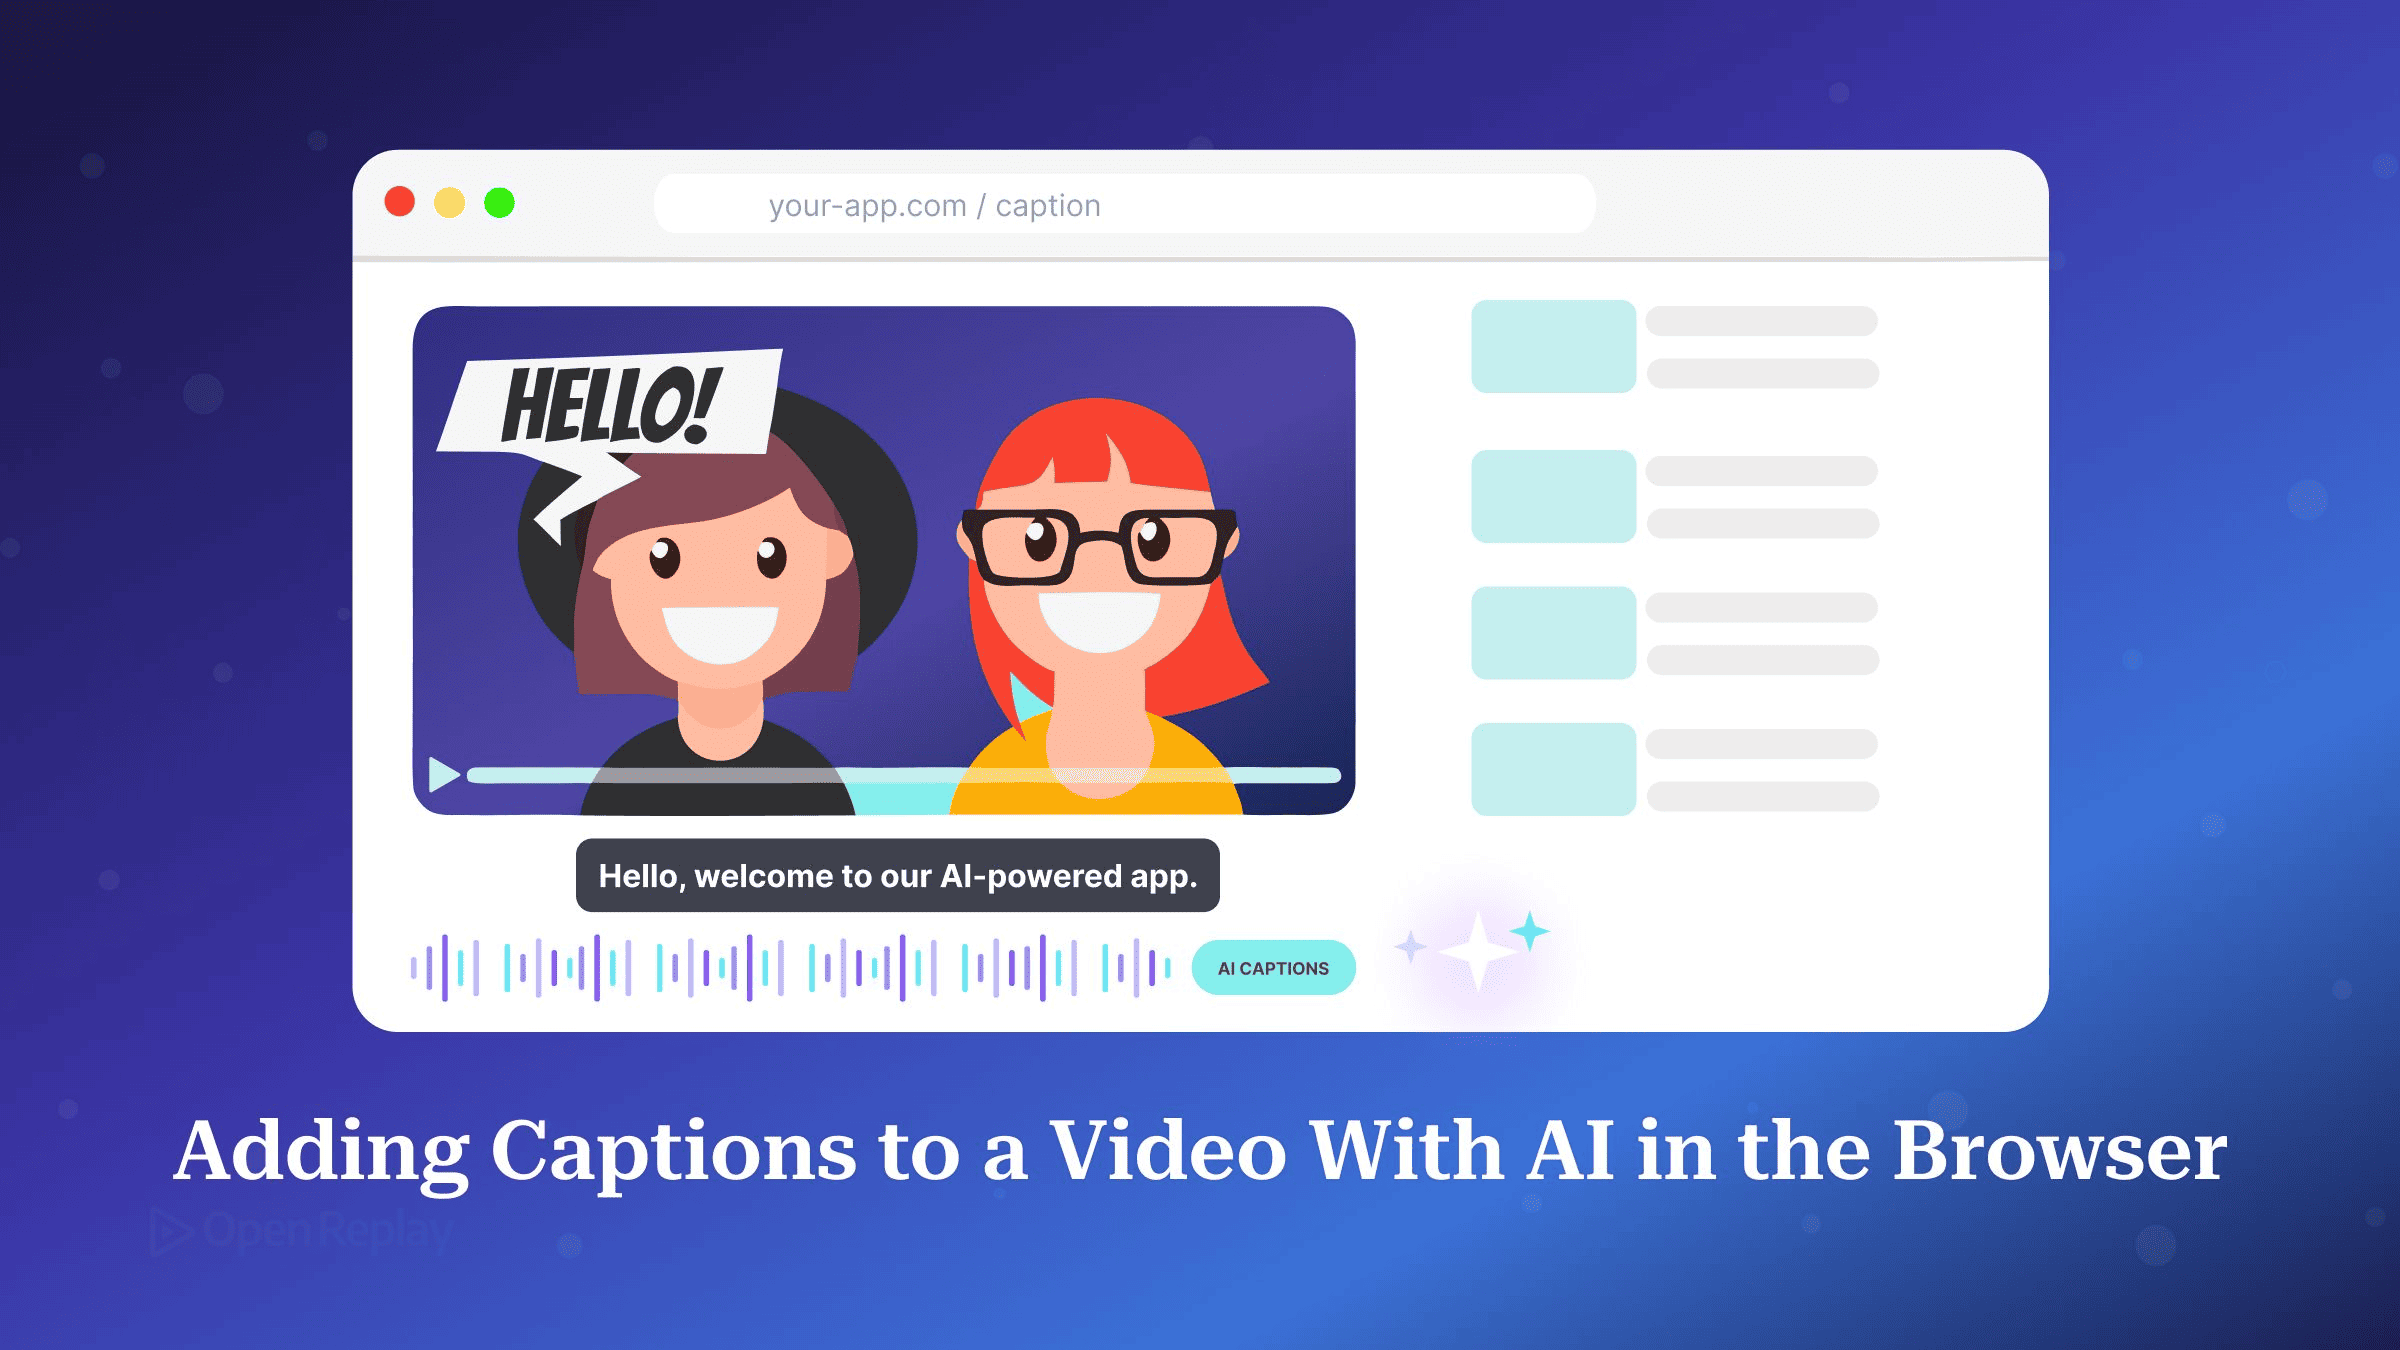
Transformers.jsを使うと、OpenAIの音声認識モデルWhisperをブラウザ上で直接実行できます。アップロードもAPIキーもサーバーも不要で、動画の音声を書き起こして字幕を作成できます。
字幕生成のチュートリアルの多くは、ユーザーの動画を文字起こしAPIに送信し、1分ごとに料金を支払うところから始まります。しかし、動画が非公開のものである場合や、新たな請求やバックエンドの保守を増やしたくない場合には、この方法は使えません。
本ガイドでは、パイプライン全体をクライアント側で構築します。音声をデコードし、WebGPU(WASMへのフォールバック付き)を使ってWeb Worker内でWhisperを実行し、出力を有効なWebVTT形式に整形して、その結果を<video>要素に追加します。
重要なポイント
- transformers.jsのWhisperは、16 kHzのモノラル音声を
Float32Arrayとして受け取ります。そのため、文字起こしの前に動画の音声トラックをデコードし、リサンプリングする必要があります。 navigator.gpuが存在しても、WebGPUが動作するとは限りません。navigator.gpu.requestAdapter()がアダプターを返した場合にのみdevice: "webgpu"を使用し、それ以外の場合はWASMにフォールバックします。- 文字起こしパイプラインはWeb Worker内で実行します。そうしないと、モデルの読み込みと推論の間ずっとメインスレッドがブロックされます。
- WebVTTファイルは
WEBVTTで始まり、キューは空行で区切られ、タイムスタンプはhh:mm:ss.ttt形式を使用します。また、キューテキスト内の&と<はエスケープが必要です。 - ブラウザ内Whisperが実用的なのは、数分程度のクリップです。1時間に及ぶ録音や大量のメディアには、ホスト型の文字起こしサービスを利用してください。
何を構築するのか、そしてなぜデバイス内で完結するのか
完成したブラウザ内字幕生成アプリは、4つの要素で構成されます。ファイル入力、<video>要素、Whisperを実行するWorker、そして字幕トラックとして追加される生成済みの.vttファイルです。メディアはユーザーのディスクからメモリに読み込まれ、タブの外に出ることはありません。ネットワーク通信が発生するのは、Hugging Face Hubからの初回のみのモデルダウンロードと、(自前でホスティングしない限り)ONNX RuntimeのWASMファイルの取得だけです。transformers.jsはデフォルトでこれらのファイルをCDNから読み込みます。音声や動画がどこかに送信されることはありません。
本記事では、WebCodecs、焼き付け字幕(バーンイン字幕)、MP4へのエクスポートは扱いません。字幕は独立したテキストトラックとして保持され、ブラウザが動画の上にレンダリングします。フレーム単位の処理はWebCodecsで構築するリアルタイム動画処理パイプラインの領域であり、本記事とは別の作業です。
動画から音声トラックを抽出するには?
transformers.jsのWhisperは、16 kHzでサンプリングされたモノラル音声をFloat32Arrayとして受け取ります。パイプラインは生の音声を型付き配列として受け付けますが、サンプリングレートがすでに正しいことを前提としています。パイプラインはこれをチェックしないため、異なるレートの音声を渡すと、エラーが出ないまま誤った文字起こし結果が生成されます。
ファイルの音声はdecodeAudioData()でデコードします。動画ファイルの場合、これが成功するかどうかはブラウザがサポートするコンテナとコーデックに依存します。そのため、あるブラウザでは問題なく再生できるMP4が、別のブラウザではデコードに失敗することがあります。次に、デコードしたバッファを、1チャンネル・16,000 Hzで作成したOfflineAudioContextでレンダリングします。Web Audioはソースを単一チャンネルの出力先に合わせてダウンミックスし、コンテキストのレートにリサンプリングするため、1回のレンダリングで両方の変換を行えます。
async function extractAudio(file) {
  const arrayBuffer = await file.arrayBuffer();
  const decodeCtx = new AudioContext();
  const decoded = await decodeCtx.decodeAudioData(arrayBuffer);
  await decodeCtx.close();

  const targetRate = 16000;
  const offline = new OfflineAudioContext(
    1,
    Math.ceil(decoded.duration * targetRate),
    targetRate
  );
  const source = offline.createBufferSource();
  source.buffer = decoded;
  source.connect(offline.destination);
  source.start();
  const rendered = await offline.startRendering();
  return { audio: rendered.getChannelData(0), duration: decoded.duration };
}durationは保持しておいてください。後でフォーマッターが使用します。
Transformers.jsのWhisperをWeb Workerで実行する
transformers.jsのASRパイプラインを呼び出す際は、return_timestamps: trueを渡します。すると出力にchunks配列が含まれるようになり、各要素にはtext文字列と、秒単位のtimestamp: [start, end]のペアが含まれます。ページの応答性を保つため、パイプラインはWeb Worker内で実行します。そうしないと、モデルの読み込みと推論の間ずっとメインスレッドがブロックされます。
npm install @huggingface/transformersでパッケージをインストールします。Workerはパイプラインを一度だけ作成し、以降はすべてのファイルでそれを再利用します。
// worker.js
import { pipeline } from "@huggingface/transformers";

let transcriberPromise;

async function pickDevice() {
  if (!("gpu" in navigator)) return "wasm";
  try {
    const adapter = await navigator.gpu.requestAdapter();
    return adapter ? "webgpu" : "wasm";
  } catch {
    return "wasm";
  }
}

function getTranscriber() {
  transcriberPromise ??= pickDevice().then((device) =>
    pipeline("automatic-speech-recognition", "onnx-community/whisper-tiny.en", { device })
  );
  return transcriberPromise;
}

self.onmessage = async ({ data }) => {
  try {
    const transcriber = await getTranscriber();
    const output = await transcriber(data.audio, {
      return_timestamps: true,
      chunk_length_s: 30,
      stride_length_s: 5,
    });
    self.postMessage({ type: "done", chunks: output.chunks });
  } catch (err) {
    self.postMessage({ type: "error", message: String(err) });
  }
};メインスレッドでは、サンプルをコピーするのではなく、バッファを転送(transfer)してWorkerに送ります。new URL(..., import.meta.url)という書き方はViteが認識するWorkerのパターンであり、webpack 5も同様に処理できます。
const worker = new Worker(new URL("./worker.js", import.meta.url), { type: "module" });

function transcribe(audio) {
  return new Promise((resolve, reject) => {
    worker.onmessage = ({ data }) =>
      data.type === "done" ? resolve(data.chunks) : reject(new Error(data.message));
    worker.postMessage({ audio }, [audio.buffer]);
  });
}Whisperは30秒単位のウィンドウで処理を行います。chunk_length_sを省略すると、transformers.jsは音声の最初の30秒だけを保持して警告をログに出力するため、それ以降の部分には字幕が付きません。chunk_length_s: 30とstride_length_s: 5を指定すると、パイプラインは長い音声を重なり合う30秒ずつの断片に分割し、その結果を結合して1つのタイムスタンプ付きチャンク群にまとめます。
WebGPUとWASM:読み込み前にデバイスを選択する
Transformers.jsでWhisperをWebGPU上で実行するのは、navigator.gpu.requestAdapter()がアダプターを返した場合に限り、それ以外の場合はWASMで実行すべきです。GPUへの切り替えは、モデルの読み込み時にdevice: "webgpu"というパイプラインオプションを1つ指定するだけです。ただし、navigator.gpuが存在しても、WebGPUが動作する保証はありません。nullを返す可能性があるrequestAdapter()を呼び出し、アダプターが返された場合にのみWebGPUを選択してください。navigator.gpuはWorker内でも公開されているため、前述のpickDevice()はWorker内で実行できます。
| 条件 | デバイス | ユーザーが得る結果 |
|---|---|---|
navigator.gpuが存在しない | "wasm" | 低速な文字起こし(CPUのみ) |
navigator.gpuは存在するが、requestAdapter()がnullを返す | "wasm" | 低速な文字起こし(CPUのみ) |
| アダプターが返される | "webgpu" | GPUアクセラレーションによる推論 |
実際のマシンでは、アダプターがnullになるケースは珍しくありません。ChromeのWebGPUトラブルシューティングガイドには、よくある原因として次のものが挙げられています。ユーザーが設定でグラフィックアクセラレーションを無効にしている、GPUがChromeのブロックリストに登録されている、そのプラットフォームでまだWebGPUがサポートされていない、あるいはChromeがGPUをまったく検出できない、といったケースです。pickDevice()のように、パイプラインを作成する前に自分でアダプターを確認すれば、これらすべてに対応できます。
Hugging Faceのガイドによると、2026年3月時点でのWebGPUのグローバルなサポート率は約85%です。WebGPUの実装状況ページでは、Windows、macOS、ChromeOSではChrome 113以降、大半のAndroidデバイスではChrome 121以降でデフォルトで有効になっているとされています。LinuxのChromeでは、一部のGPUでのみ有効になります。Firefoxでは、Windowsではバージョン141以降、Apple Silicon搭載のMacではバージョン147以降でデフォルトで有効です。Safari 26は、macOS、iOS、iPadOS、visionOSでWebGPUをサポートしています。Android版Firefoxでは引き続きデフォルトで無効になっており、利用するにはFirefox BetaまたはNightlyに加え、about:configでgfx.webgpu.ignore-blocklistを設定する必要があります。
WhisperのチャンクをWebVTTに変換するには?
Whisperの各チャンクは、1つのWebVTTキューになります。開始時刻と終了時刻はタイミング行に、テキストはその下の行に記述します。ルールはMDNのWebVTTリファレンスに記載されています。ファイルはWEBVTTで始まり、各キューは空行で区切られ、-->でつないだ2つのタイムスタンプによって各キューの表示タイミングを指定します。
以下のフォーマッターは、常に長い形式のhh:mm:ss.tttで出力します。時間は2桁以上、分と秒は59を超えず、ミリ秒部分は常に3桁です。また、すべてのキューは開始時刻より後に終了しなければなりません。キューテキストには、&と<の2文字をそのまま含めることができません。コードではまず&を&に、次に<を<に置換します。MDNでは>も>と記述することを推奨しているため、コードではこれも行っています。
const pad = (n, width = 2) => String(n).padStart(width, "0");
function toVttTime(seconds) {
const total = Math.round(seconds * 1000);
const h = Math.floor(total / 3_600_000);
const m = Math.floor((total % 3_600_000) / 60_000);
const s = Math.floor((total % 60_000) / 1000);
const ms = total % 1000;
return `${pad(h)}:${pad(m)}:${pad(s)}.${pad(ms, 3)}`;
}
function escapeCueText(text) {
return text.replace(/&/g, "&").replace(/</g, "<").replace(/>/g, ">");
}
function chunksToVtt(chunks, duration) {
const cues = [];
for (const { text, timestamp } of chunks) {
const [start, end] = timestamp;
const stop = end ?? duration;
const body = escapeCueText(text.replace(/\s+/g, " ").trim());
if (!body || stop <= start) continue;
cues.push(`${toVttTime(start)} --> ${toVttTime(stop)}\n${body}`);
}
return `WEBVTT\n\n${cues.join("\n\n")}\n`;
}ここでは、いくつかの細かな点が重要です。
toVttTimeは、値を時・分・秒に分割する前にミリ秒単位で丸めるため、.1000が出力されることはありません。&を最初にエスケープしているのは、他の置換処理がアンパサンドを追加するためです。最後にエスケープすると、それらが二重にエスケープされてしまいます。- 空白文字をまとめることで、モデルが出力したテキスト内の改行が除去されます。ペイロード内に空行があると、キューがそこで途中終了してしまいます。
?? durationのフォールバックは、最後のチャンクが終了時刻なしで返された場合に備えた予防策です。
フォーマッターの出力は次のようになります(例)。
WEBVTT

00:00:00.000 --> 00:00:04.320
Welcome back. Today we are wiring up captions.

00:00:04.320 --> 00:00:09.100
The model runs in a worker & nothing is uploaded.VTTファイルがあれば、字幕を他の言語に翻訳することもできます。
Blob URLで字幕を追加する
字幕を表示するには、VTT文字列をtext/vttタイプのBlobでラップしてオブジェクトURLを作成し、そのURLを<track>要素のsrcとして使用します。トラックにはkind="captions"、srclang、defaultを指定します。BlobコンストラクターはJavaScriptの文字列をUTF-8でエンコードしますが、これはWebVTTが要求するエンコーディングです。
function attachCaptions(video, vtt) {
  const url = URL.createObjectURL(new Blob([vtt], { type: "text/vtt" }));
  const track = document.createElement("track");
  track.kind = "captions";
  track.srclang = "en";
  track.label = "English (auto-generated)";
  track.src = url;
  track.default = true;
  video.append(track);
  track.track.mode = "showing";
  return () => URL.revokeObjectURL(url);
}whisper-tiny.enは英語専用モデルであるため、srclangは"en"にしています。トラックは動画の読み込み完了後に追加されるため、modeを明示的に"showing"に設定することで、すぐに表示されるようにしています。動画を差し替えたり削除したりする際には、返された関数を呼び出してオブジェクトURLを解放してください。Reactの場合は、Reactでの動画の埋め込みやReactで動画プレーヤーを構築するで解説しているように、レンダリングする<video>の中に同じトラックを配置します。
ブラウザ内Whisperの制限は?
ブラウザ内Whisperは、数分程度のクリップではうまく機能しますが、1時間に及ぶ録音には不向きです。
- ダウンロードサイズ:初回実行時には、バリアントに応じて数十MBから数百MBのモデルの重みがダウンロードされます。
whisper-tiny.enのモデルページにはファイルへのリンクがあります。Hugging Face Hubにある大きめのWhisperバリアントは精度が高い一方でサイズも大きいため、切り替える前に各モデルカードを確認してください。 - 速度:長いファイルの処理は、特にWASM経由では低速です。数分程度の音声なら問題ありませんが、1時間の音声ではタブが長時間占有されます。
- メモリ:デコードされた音声全体が、型付き配列としてメモリ上に保持されます。
- 大量または長時間のメディア:1時間に及ぶ録音やバッチ処理には、ホスト型の文字起こしサービスのほうが適しています。
まとめ
短い動画であれば、ブラウザだけで完結して字幕を付けることができます。音声をデコードしてリサンプリングし、Worker内でWebGPU(アダプターが利用できない場合はWASM)を使ってWhisperを実行し、チャンクをWebVTTに整形して、Blobを基にしたトラックとして追加するだけです。まずは2分程度のクリップでwhisper-tiny.enを試し、キューのタイミングを音声と照らし合わせて確認してください。より大きなHubモデルに移行するのは、精度が十分でなく、かつユーザーがより大きなダウンロードを許容できる場合に限りましょう。
よくある質問
transformers.jsはページを読み込むたびにWhisperモデルをダウンロードしますか?
いいえ。初回実行時にtransformers.jsはモデルファイルをダウンロードしてブラウザキャッシュに保存するため、以降の読み込みではネットワークではなくキャッシュから読み込まれます。この動作はenv.useBrowserCache設定で制御します。transformers.js v4では、ModelRegistry.is_pipeline_cachedでパイプラインのファイルがすでにキャッシュされているかどうかを確認でき、ModelRegistry.clear_pipeline_cacheでそれらを削除できます。
Worker内でWhisperを読み込む際に、モデルのダウンロード進捗を表示するにはどうすればよいですか?
パイプラインのオプションで、deviceと並べてprogress_callback関数を渡します。Transformers.jsは、各モデルファイルのダウンロード中にステータス更新を伴ってこの関数を呼び出します。Worker内では、各更新をpostMessageでメインスレッドに転送し、そこでプログレスバーを描画します。Transformers.js v4ではprogress_totalイベントが追加され、全体の読み込み進捗が報告されるため、ファイルごとの更新を自分で合算する必要がなくなりました。
英語以外の動画にも字幕を生成できますか?
はい。ただし、末尾が.enの英語専用モデルではなく、多言語対応のWhisperチェックポイントが必要です。transcriberの呼び出し時にlanguageとtaskを渡します。たとえば、language: 'french'とtask: 'transcribe'のように指定します。taskを'translate'に設定すると、Whisperは他言語の音声から英語のテキストを生成します。トラックのsrclangには、音声の言語ではなく字幕テキストの言語を設定してください。
Hugging Face HubやCDNに接続せずに字幕生成アプリを実行できますか?
はい。すべてのファイルをセルフホスティングすれば可能です。env.allowRemoteModelsをfalseに設定し、env.localModelPathにモデルファイルを格納したサーバー上のフォルダーを指定します。デフォルトではONNX RuntimeのWASMバイナリもCDNから読み込まれるため、env.backends.onnx.wasm.wasmPathsも自前のコピーを指すように設定してください。完全なオフライン利用を実現するには、Service Workerを追加して、接続がなくてもページ自体を読み込めるようにします。
Gain Debugging Superpowers
Unleash the power of session replay to reproduce bugs, track slowdowns and uncover frustrations in your app. Get complete visibility into your frontend with OpenReplay — the most advanced open-source session replay tool for developers.
Star on GitHub12k